Einstieg
Von Wildcards zur Ähnlichkeitssuche
Jeder erinnert sich noch, wie die Produktsuche in Webshops früher funktioniert hat. Der Suchbegriff musste genau passen. Mit etwas Glück durfte man wenigstens mit Wildcards suchen. Heute reicht in vielen Shops ein ungefährer Begriff. Selbst wer das Gesuchte mit ganz anderen Worten beschreibt, bekommt meist passende Treffer.
Dahinter steckt in vielen Fällen keine klassische SQL-Abfrage, sondern eine Similarity Search. Ein Sprachmodell übersetzt Texte in Vektoren, sogenannte Embeddings. Texte mit ähnlicher Bedeutung liegen in diesem Vektorraum nah beieinander. Die Suche vergleicht also nicht Zeichenketten, sondern Bedeutungen. Dafür braucht es Tabellen, die Vektoren speichern und schnell vergleichen können.
Dasselbe Prinzip ist ein zentraler Baustein heutiger KI-Assistenten und Agenten. Sprachmodelle wie GPT arbeiten intern selbst mit Embeddings. Sobald ein Assistent oder Agent Antworten aus Dokumenten oder Unternehmenswissen liefert, steckt meist Retrieval Augmented Generation (RAG) dahinter. Die Inhalte werden in Abschnitte zerlegt und als Vektoren in einer Vektordatenbank abgelegt. Zu jeder Frage sucht eine Similarity Search die passenden Abschnitte und gibt sie dem Modell mit. Die File Search von OpenAI basiert zum Beispiel auf solchen Vector Stores, und viele Agenten nutzen denselben Mechanismus als Gedächtnis.
SAP HANA Cloud hat dafür seit dem Release QRC1/2024, also seit gut zweieinhalb Jahren, eine eigene Vector Engine mit dem Datentyp REAL_VECTOR und Ähnlichkeitsfunktionen wie COSINE_SIMILARITY. Seitdem sind unter anderem HNSW-Indizes für schnelle Suchen hinzugekommen und mit QRC4/2024 die Funktion VECTOR_EMBEDDING. Damit kann HANA Texte selbst einbetten, also die Vektoren direkt in der Datenbank berechnen. Wie das zusammen mit Integration Suite und Build Apps eine vollständige Anwendung ergibt, zeige ich am öffentlichen Produktkatalog der Modekette H&M.
Überblick
Die Gesamtarchitektur
Der End User gibt in einer Web-App aus SAP Build Apps einen Suchtext ein, auf Deutsch, obwohl die Produkttexte englisch sind. Die Anfrage läuft über eine BTP Destination zu einem iFlow in Cloud Integration, die Zugangsdaten dafür liefert eine Service-Instanz von Process Integration Runtime. Der iFlow ruft per JDBC eine Suchfunktion in SAP HANA Cloud auf und gibt das Ergebnis als JSON zurück. Die Daten wurden vorher einmalig von Hugging Face geladen.
Teil 1
Die Datenbasis in SAP HANA Cloud
1.1Der Datensatz: H&M-Katalog von Hugging Face
Grundlage ist Qdrant/hm_ecommerce_products, eine unter CC BY 4.0 veröffentlichte, aufbereitete Fassung des Kaggle-Datensatzes von H&M. Die Parquet-Datei mit 247 MB beschreibt 105.126 Artikel: Name, Produktart, Farbe, Abteilung, Beschreibung und Bild-URL. Das Feld
text_to_embedverkettet die wichtigsten Attribute und die Beschreibung zu einem Text. Mitgeliefert ist außerdem ein Vektor des englischen Modells BGE-small-en mit 384 Dimensionen.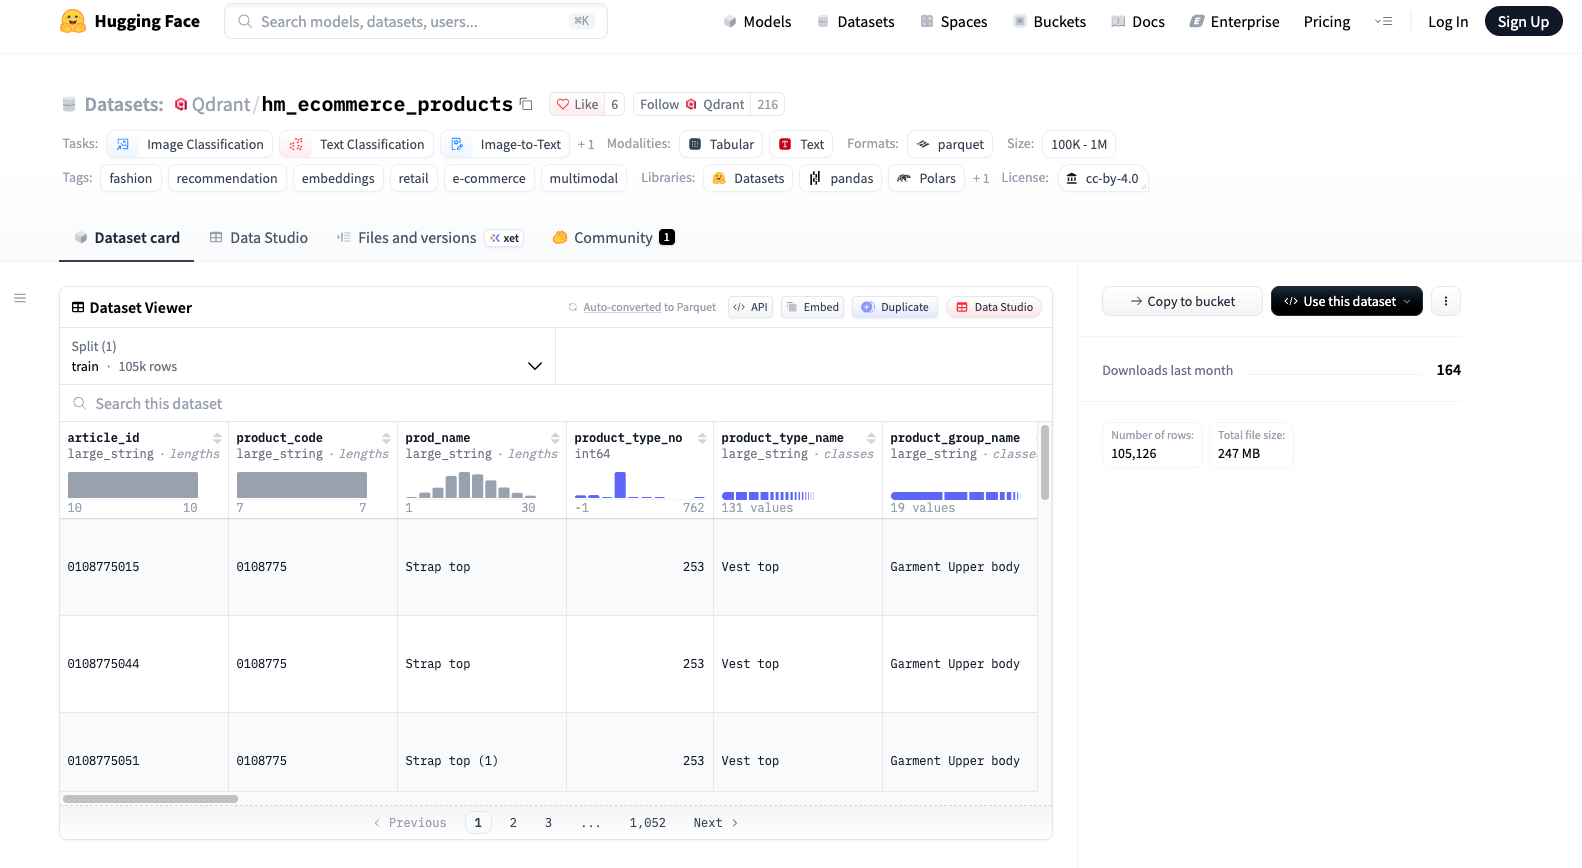
Der Datensatz auf Hugging Face: 105.126 Zeilen, 247 MB, Lizenz CC BY 4.0. 1.2Die Vektortabelle HM_PRODUCTS
In HANA liegt der Katalog in der Spaltentabelle
HM_PRODUCTSim SchemaMATERIAL_VEKTOR_DEMO. Die Artikelattribute sind normale Spalten, daneben stehen die Vektorspalten mit dem nativen TypREAL_VECTOR.EMBEDDING_384enthält den mitgelieferten englischen Vektor.EMBEDDING_768hat HANA selbst berechnet, dazu mehr im nächsten Abschnitt. Ein HNSW-Index auf der Vektorspalte sorgt dafür, dass die Ähnlichkeitssuche über alle Artikel in Sekundenbruchteilen läuft.Struktur von HM_PRODUCTS (gekürzt)CREATE COLUMN TABLE HM_PRODUCTS ( ARTICLE_ID NVARCHAR(10) NOT NULL PRIMARY KEY, PROD_NAME NVARCHAR(200), PRODUCT_TYPE_NAME NVARCHAR(100), COLOUR_GROUP_NAME NVARCHAR(100), -- ... weitere Attribute: Produktgruppe, Muster, Abteilung, Index ... DETAIL_DESC NVARCHAR(5000), TEXT_TO_EMBED NVARCHAR(5000), IMAGE_URL NVARCHAR(500), EMBEDDING_384 REAL_VECTOR(384), -- mitgeliefert, BGE-small-en EMBEDDING_768 REAL_VECTOR(768) -- berechnet in HANA, SAP_NEB); CREATE HNSW VECTOR INDEX HM_PRODUCTS_EMB768_IDX ON HM_PRODUCTS (EMBEDDING_768) SIMILARITY FUNCTION COSINE_SIMILARITY;
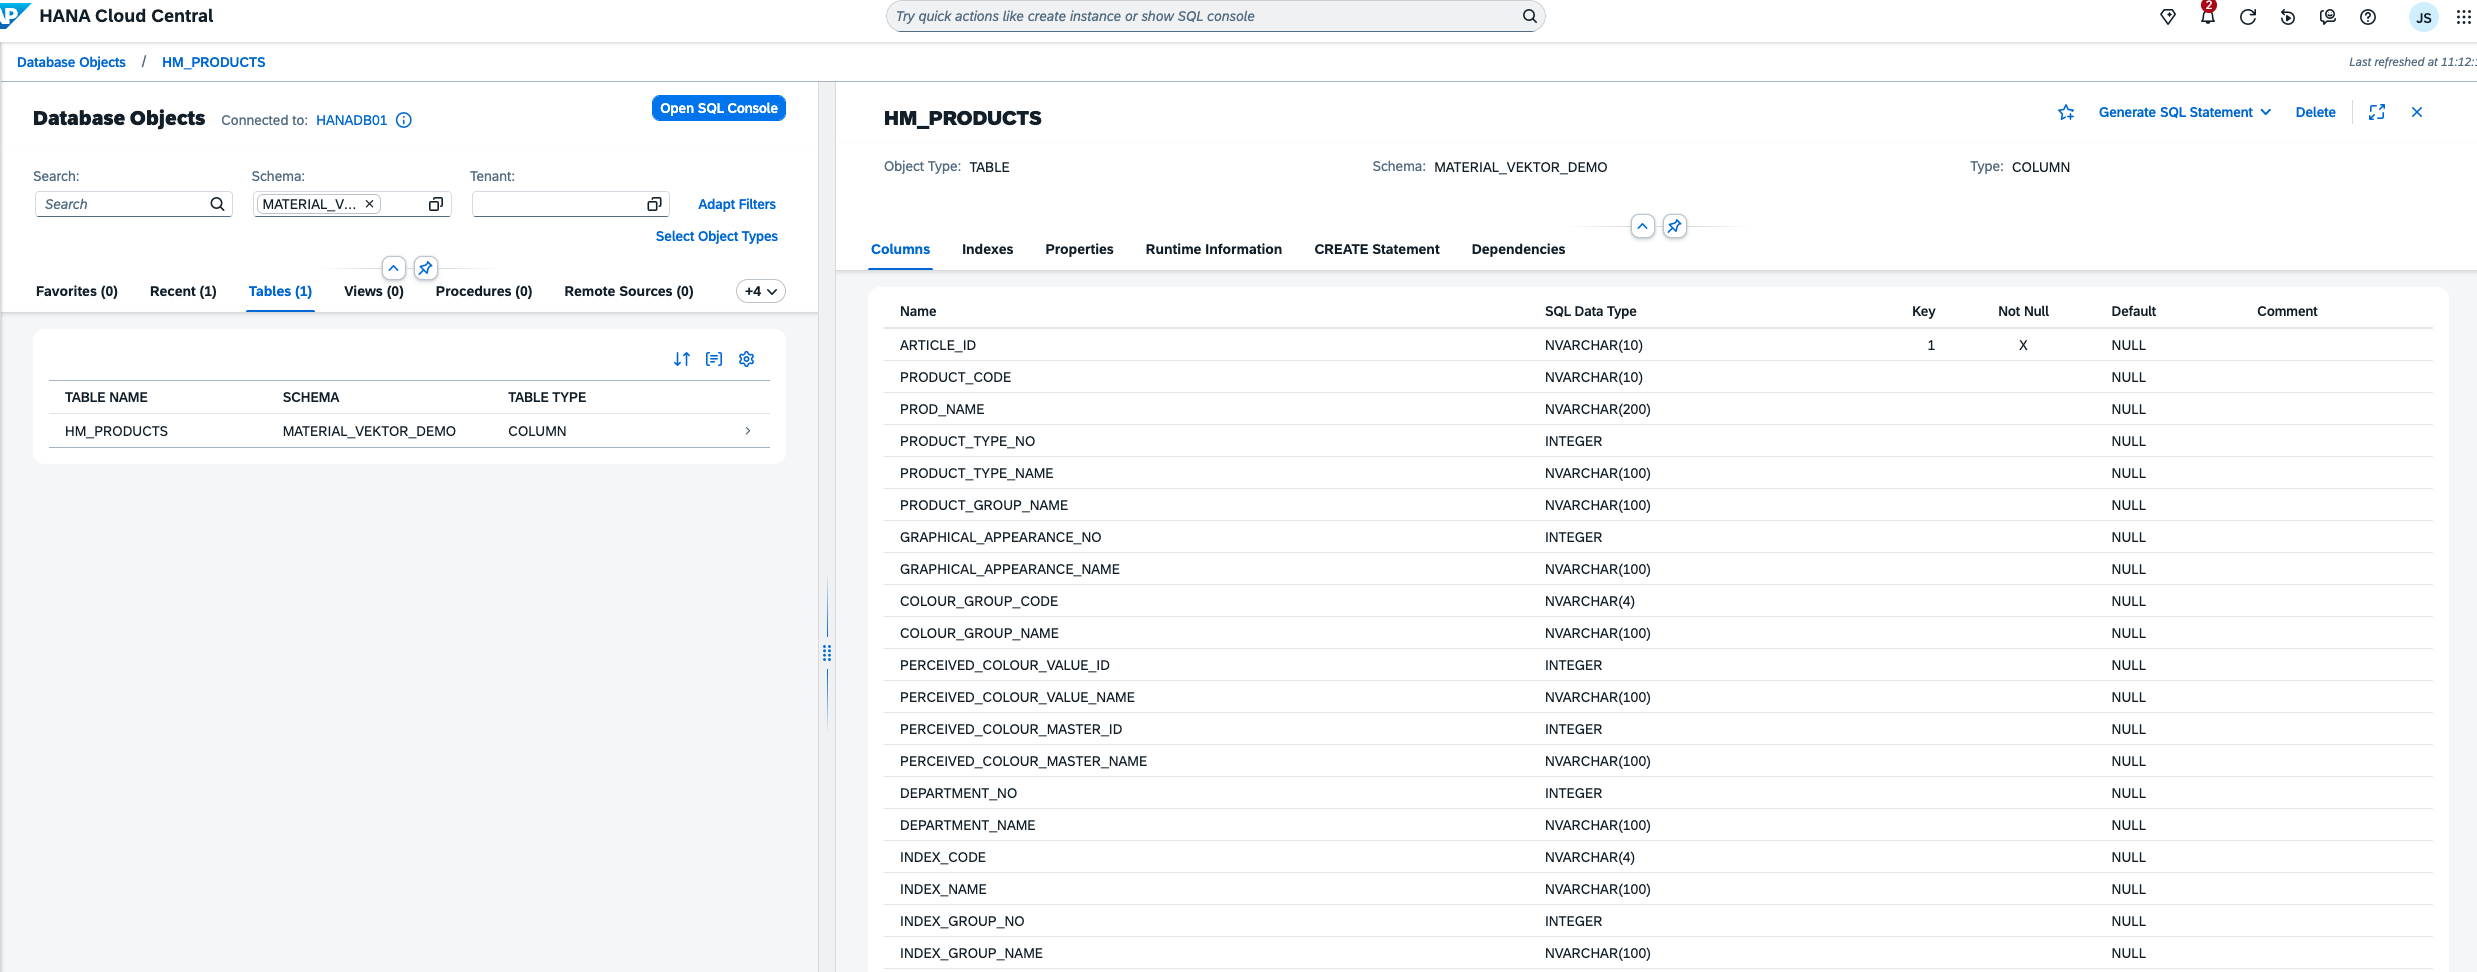
Die Tabelle HM_PRODUCTS in SAP HANA Cloud Central. 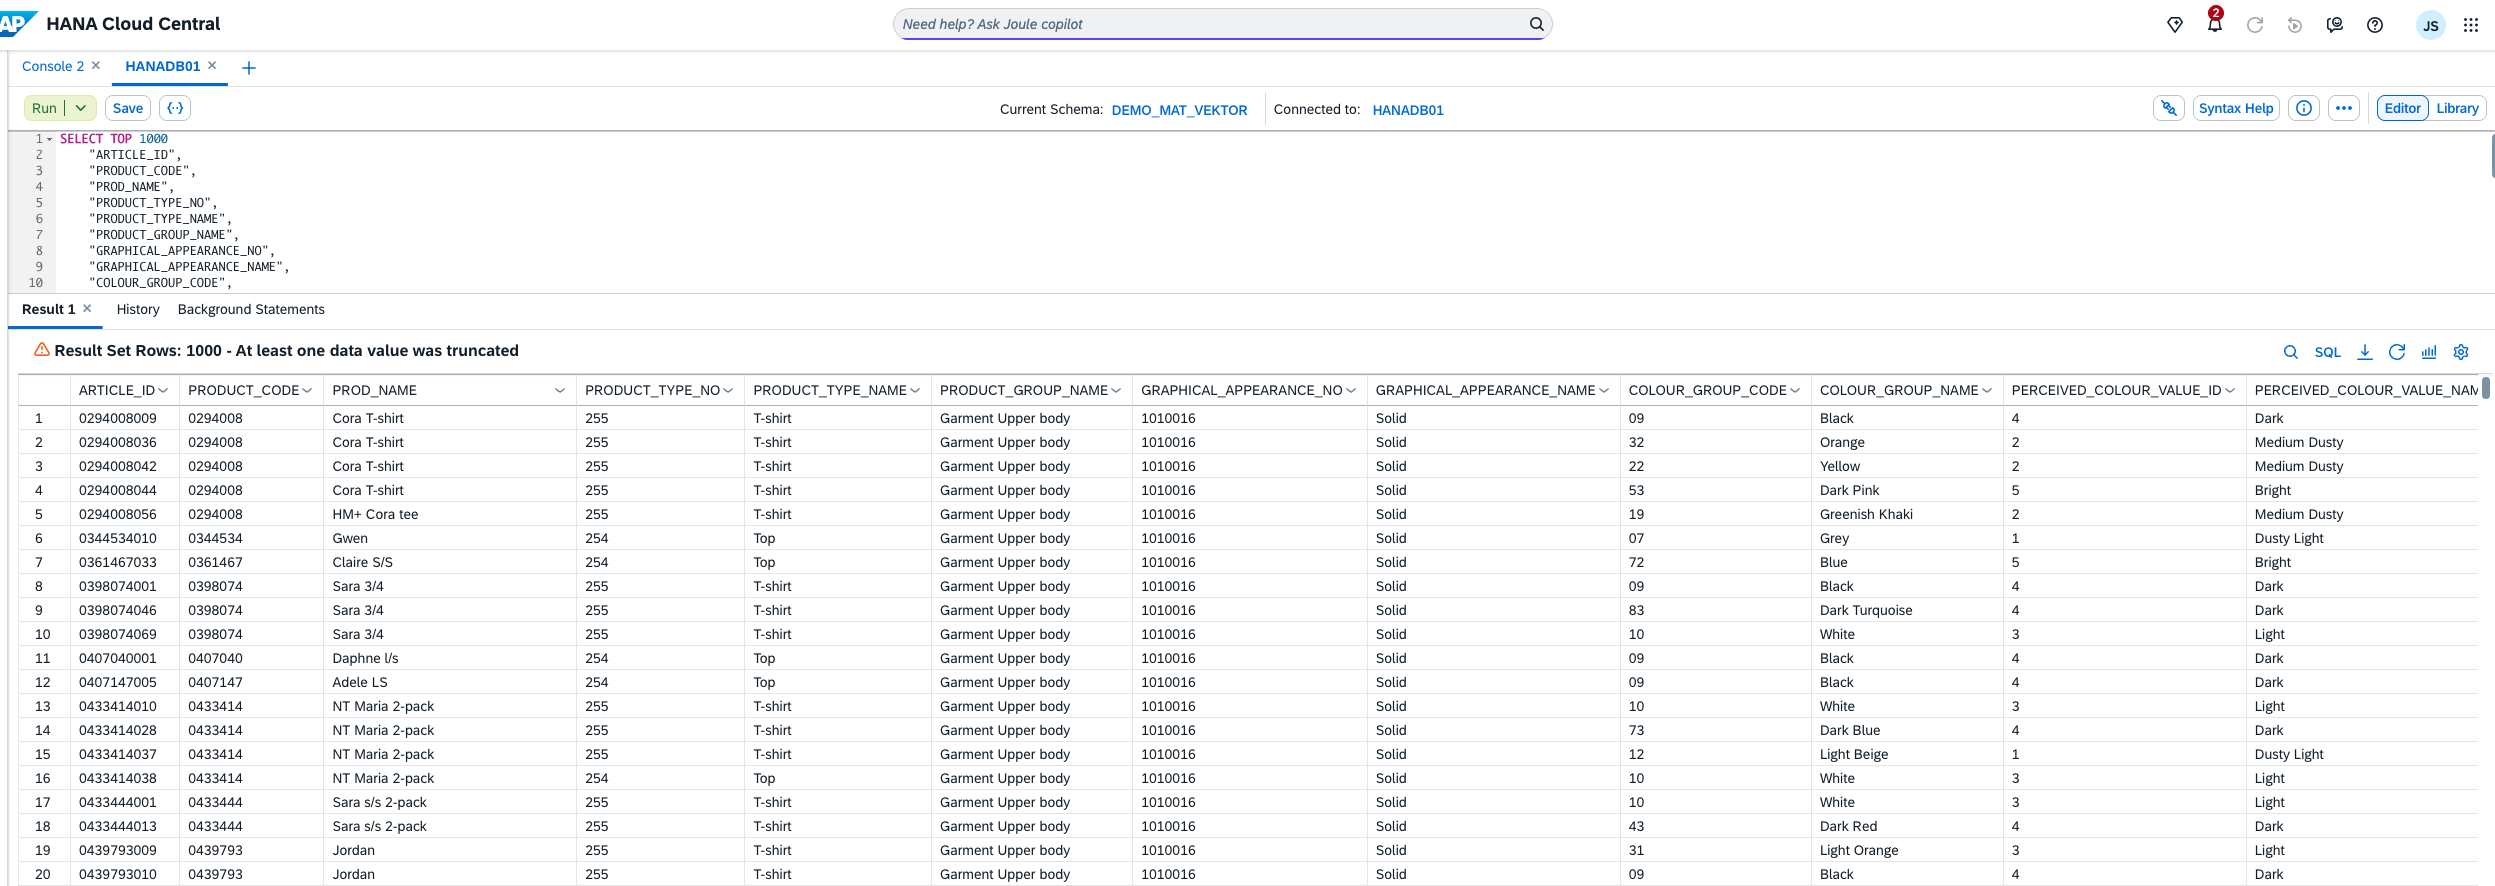
Auszug aus HM_PRODUCTS in der SQL-Konsole. 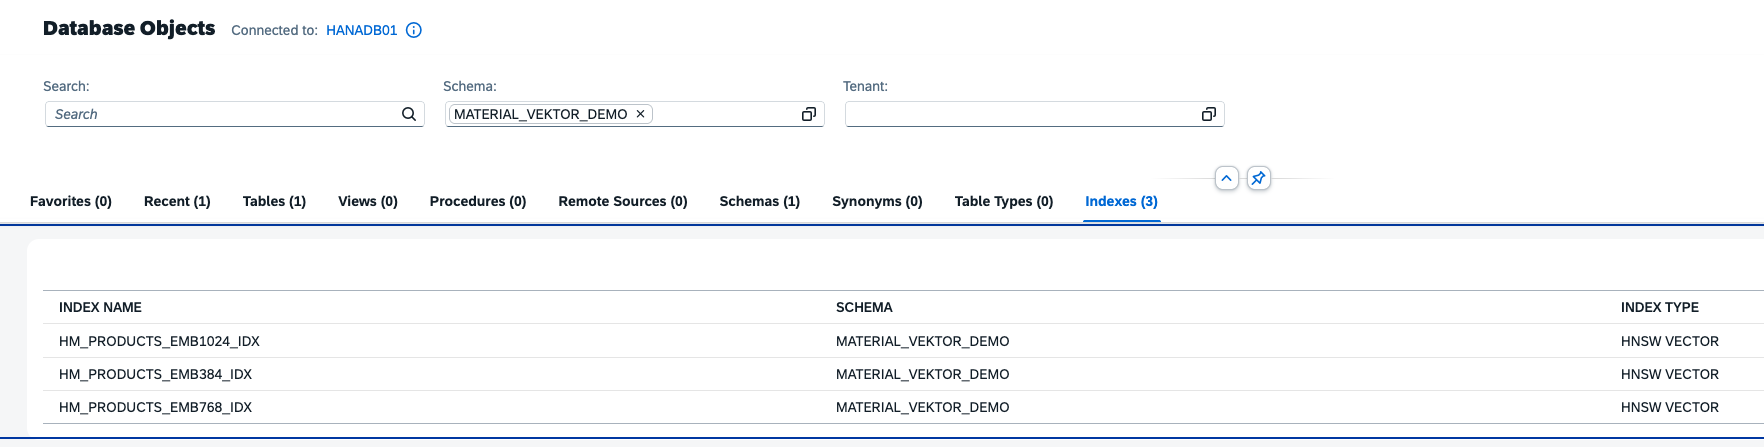
HNSW-Vektorindizes auf HM_PRODUCTS. Die App nutzt den Index auf EMBEDDING_768. 1.3Das Embedding: SAP_NEB direkt in der Datenbank
Warum eine zweite Vektorspalte? Der mitgelieferte Vektor hat zwei Haken. Erstens muss jede Suchanfrage mit demselben Modell eingebettet werden wie die Produkte. Jede Schicht vor der Datenbank, hier der iFlow, bräuchte also Zugriff auf BGE-small-en, als eigenen Dienst mit eigenem Betrieb. Zweitens versteht das Modell nur Englisch, im DACH-Raum ein K.-o.-Kriterium.
EMBEDDING_768löst beides. HANA berechnet die Vektoren mit der FunktionVECTOR_EMBEDDINGund dem SAP-ModellSAP_NEB.20240715, das unter anderem Deutsch und Englisch versteht. Die Produkttexte sind als'DOCUMENT'eingebettet, Suchanfragen werden zur Laufzeit als'QUERY'eingebettet. Die Texte verlassen die Datenbank dabei nie, und keine Schicht davor braucht ein eigenes Sprachmodell.Herkunft der Werte in EMBEDDING_768VECTOR_EMBEDDING(TEXT_TO_EMBED, 'DOCUMENT', 'SAP_NEB.20240715')Wie groß der Unterschied ist, zeigt ein Vergleich deutscher Anfragen auf die englischen Produkttexte:
Suchanfrage Mitgelieferter Vektor (BGE-small-en, 384) Embedding in HANA (SAP_NEB, 768) schwarzes Sommerkleid ✗Hosen (Stella Pull on TRS) ✓SUMMER STRAP DRESS, Summer strap dress, DIV summer strap dress, alle schwarz warme Winterjacke für Herren ✗Fleece-Overalls für Babys ✓Home Parka, Douglas puffer, Skijacken aus Menswear gestreiftes Hemd fürs Büro ✗Hosen, Pullover ✗Weste, Hosen Das HANA-Embedding versteht sogar Zielgruppen wie „für Herren“. Die letzte Zeile zeigt die Grenze: Merkmale wie „gestreift“ erfasst ein Embedding allein nicht zuverlässig, dafür braucht es strukturierte Filter.
1.4Die Suchfunktionen
Die gesamte Suchlogik steckt in zwei Tabellenfunktionen. Weil HANA auch die Anfrage selbst einbettet, nehmen beide nur Text entgegen und liefern die Treffer samt Attributen, Bild-URL und Score zurück.
SEARCH_PRODUCTS_VECTORist die reine Vektorsuche über Cosine Similarity.SEARCH_PRODUCTS_HYBRIDkombiniert sie mit einer unscharfen Keyword-Suche (CONTAINS … FUZZY) und verschmilzt beide Ranglisten per Reciprocal Rank Fusion. Das hilft bei Produkt- oder Serienbezeichnungen, die kein Sprachmodell kennt. Beide Funktionen laufen mitSQL SECURITY INVOKER, also mit den Rechten des Aufrufers.SEARCH_PRODUCTS_VECTOR (Kern)-- Suchtext einmal pro Aufruf einbetten, nicht pro ZeileDECLARE LV_QUERY_VECTOR REAL_VECTOR(768) = VECTOR_EMBEDDING(:IV_QUERY_TEXT, 'QUERY', 'SAP_NEB.20240715'); SELECT ARTICLE_ID, COSINE_SIMILARITY(EMBEDDING_768, :LV_QUERY_VECTOR) AS SCORE FROM HM_PRODUCTS ORDER BY SCORE DESC LIMIT :IV_TOP_K; -- AufrufSELECT * FROM MATERIAL_VEKTOR_DEMO.SEARCH_PRODUCTS_VECTOR('schwarzes Sommerkleid', 5);
Teil 2
Integration über die SAP Integration Suite
SAP Build Apps kann nicht per JDBC oder SQL direkt auf eine Datenbank zugreifen. Externe Daten bindet die App über Webschnittstellen wie REST und OData an, schließlich läuft sie im Browser oder auf dem Mobilgerät. Zwischen App und HANA braucht es deshalb einen Webservice. In diesem Szenario ist das ein iFlow in Cloud Integration: Er nimmt einen REST-Aufruf an, übersetzt ihn in einen kontrollierten SQL-Aufruf und liefert JSON zurück, mit Monitoring und Tracing für jede Nachricht. Ein CAP-Service wäre eine mögliche Alternative.
2.1Die JDBC-Datenquelle HANA_HM_READ
Cloud Integration greift über die JDBC-Datenquelle
HANA_HM_READvom Typ SAP HANA Cloud auf die Datenbank zu. Dahinter steht der technische HANA-UserHM_SEARCH_TECH. Er darf im Demo-Schema nur lesen und die Suchfunktionen ausführen (SELECTundEXECUTE), sein Passwort läuft nicht ab.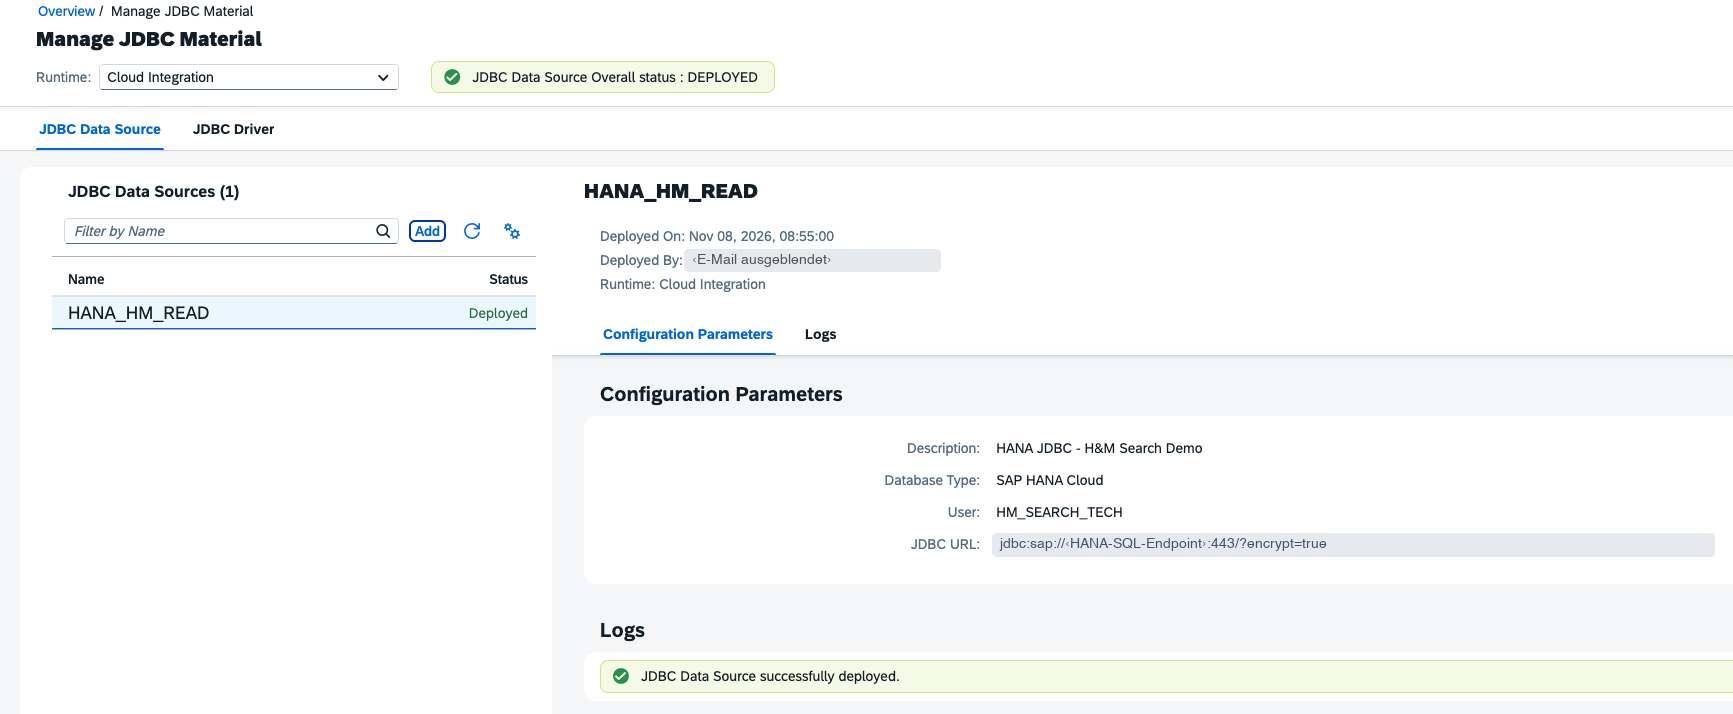
Die JDBC-Datenquelle HANA_HM_READ. E-Mail-Adresse und Datenbank-Host sind ausgeblendet. 2.2Der iFlow /hm-search: Text rein, JSON raus
Der iFlow nimmt über einen HTTPS-Sender Anfragen der Form
GET /http/hm-search?q=…&mode=vector|hybrid&top=…entgegen. Das Groovy-Skript Build SQL macht daraus den Funktionsaufruf, ein Request Reply führt ihn über den JDBC-Adapter aus, und ein zweites Skript wandelt die XML-Antwort in ein JSON-Array. Die Absicherung steckt im ersten Skript: Der Funktionsname kommt aus einer Whitelist,topist auf 1 bis 20 begrenzt, und Apostrophe werden verdoppelt. Der Suchtext bleibt so immer ein reines String-Literal. Eine Suche dauert über den iFlow etwa 1,3 Sekunden im Vektor- und 1,6 Sekunden im Hybrid-Modus.Build SQL (Groovy, Auszug)String fn = params["mode"] == "hybrid" ? "SEARCH_PRODUCTS_HYBRID" : "SEARCH_PRODUCTS_VECTOR"top = Math.max(1, Math.min(top, 20))String literal = q.replace("'", "''")message.setBody("SELECT * FROM MATERIAL_VEKTOR_DEMO.${fn}(N'${literal}', ${top})")
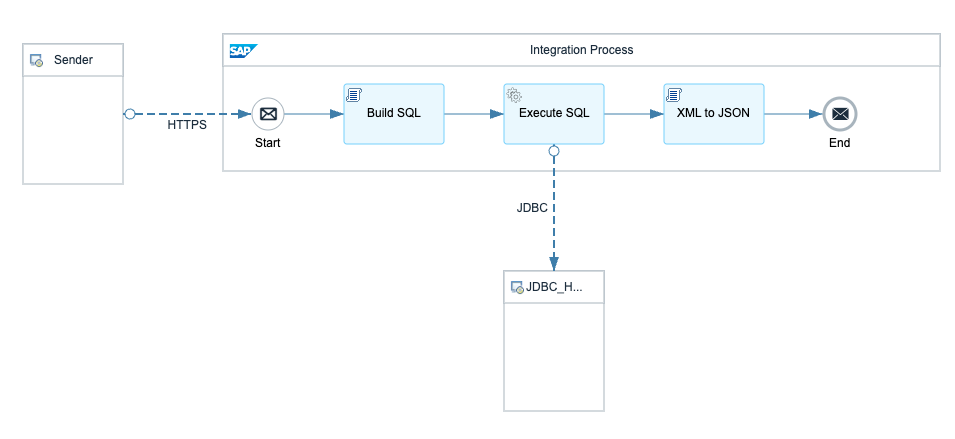
Der iFlow mit Build SQL, Execute SQL über JDBC und XML to JSON. 2.3Die Service-Instanz Process Integration Runtime
Wer den iFlow von außen aufruft, braucht Zugangsdaten. Diese stellt eine Service-Instanz von SAP Process Integration Runtime mit dem Plan
integration-flowund der RolleESBMessaging.sendbereit. Ihr Service Key enthält Client-ID und Secret, nutzbar per OAuth oder per Basic Authentication.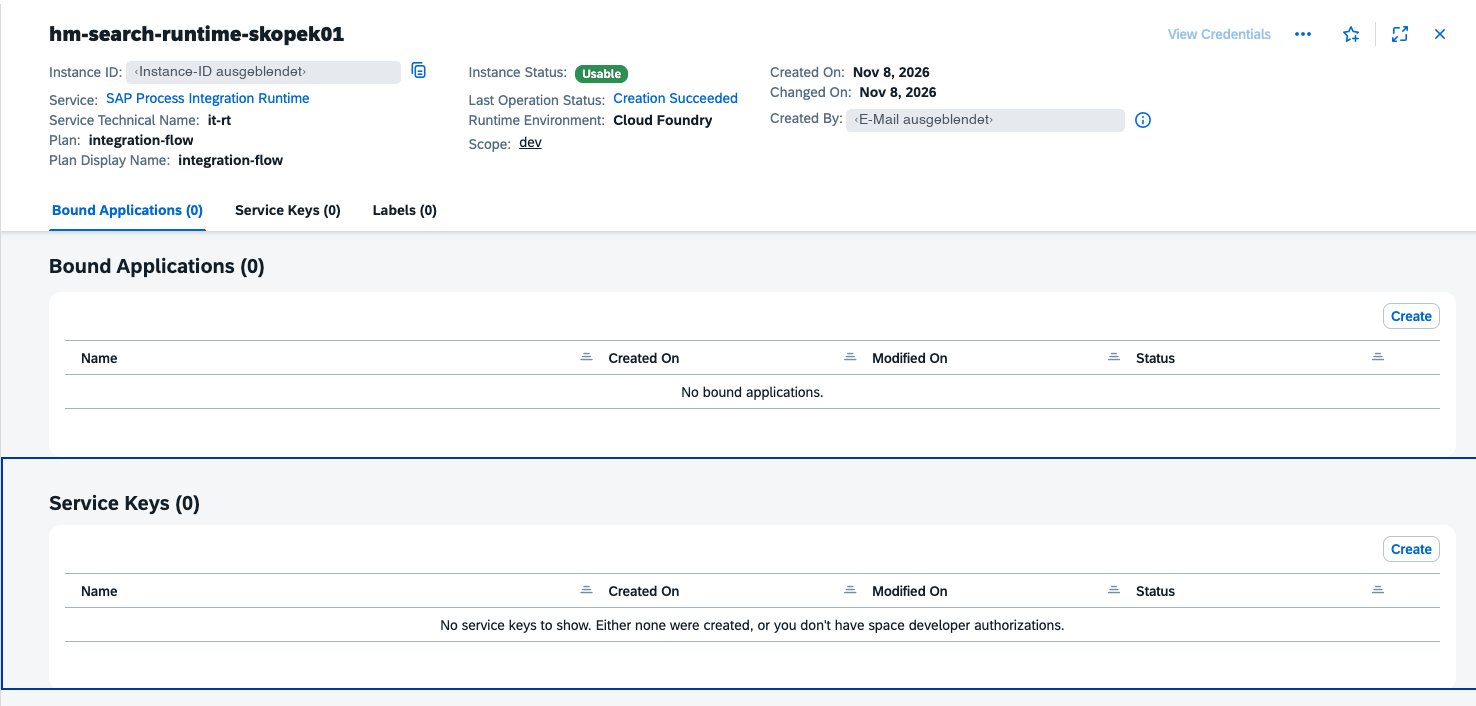
Die Service-Instanz Process Integration Runtime. Instance-ID und E-Mail-Adresse sind ausgeblendet. 2.4Die Destination HM_SEARCH_DEMO
Die BTP Destination
HM_SEARCH_DEMOist die Brücke zur App. Sie zeigt auf die Runtime-URL mit dem Pfad/httpund meldet sich mit Client-ID und Secret per Basic Authentication an. Die PropertiesAppgyverEnabledundHTML5.DynamicDestinationmachen sie für Build Apps nutzbar. Die App kennt damit weder Host noch Secret.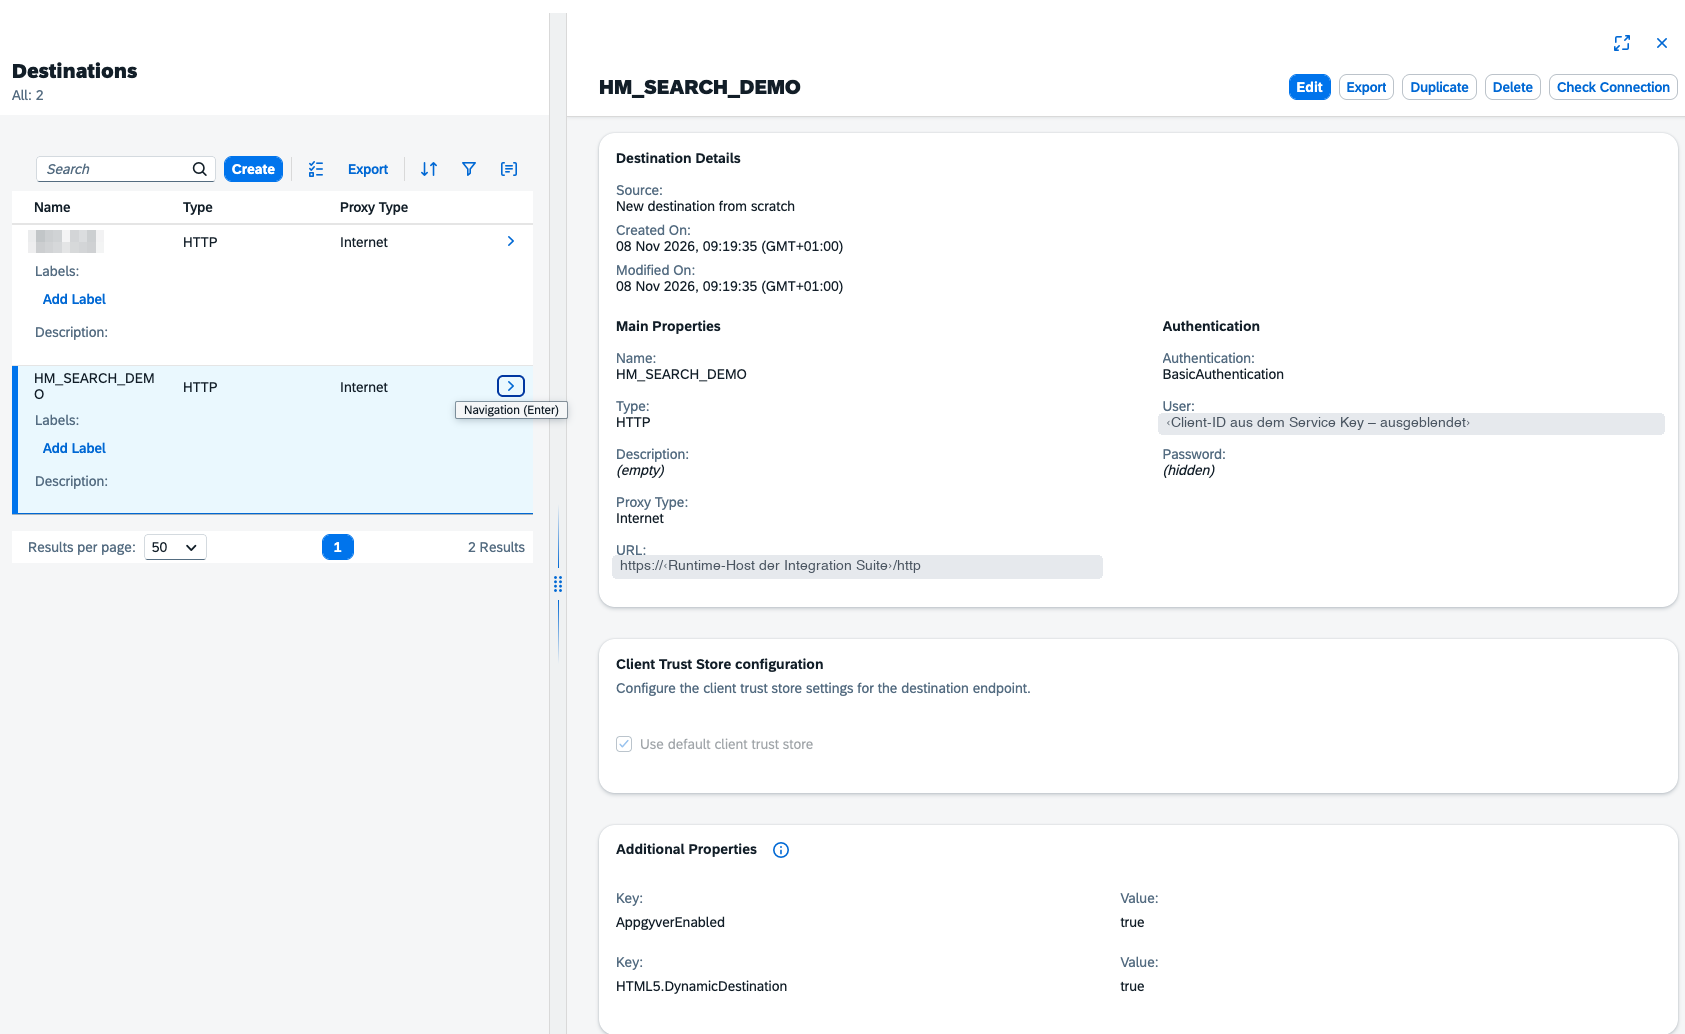
Die Destination HM_SEARCH_DEMO. Client-ID, Runtime-Host und eine nicht zugehörige Destination sind ausgeblendet.
Teil 3
Die App in SAP Build Apps
3.1Die Data Entity products
Die Web-App bindet die Destination als REST-Integration ein. Die Data Entity
productsbildet die Suche als Operationlistab. Ihr relativer Pfad ist eine Formel aus den drei Eingaben Suchtext, Modus und Trefferzahl, und der Response Mapper übernimmt das JSON-Array als Datensätze.Relative path and query (Formel)"/hm-search?q=" + ENCODE_FOR_URL(query.additionalInputs.q) + "&mode=" + query.additionalInputs.mode + "&top=" + query.additionalInputs.top
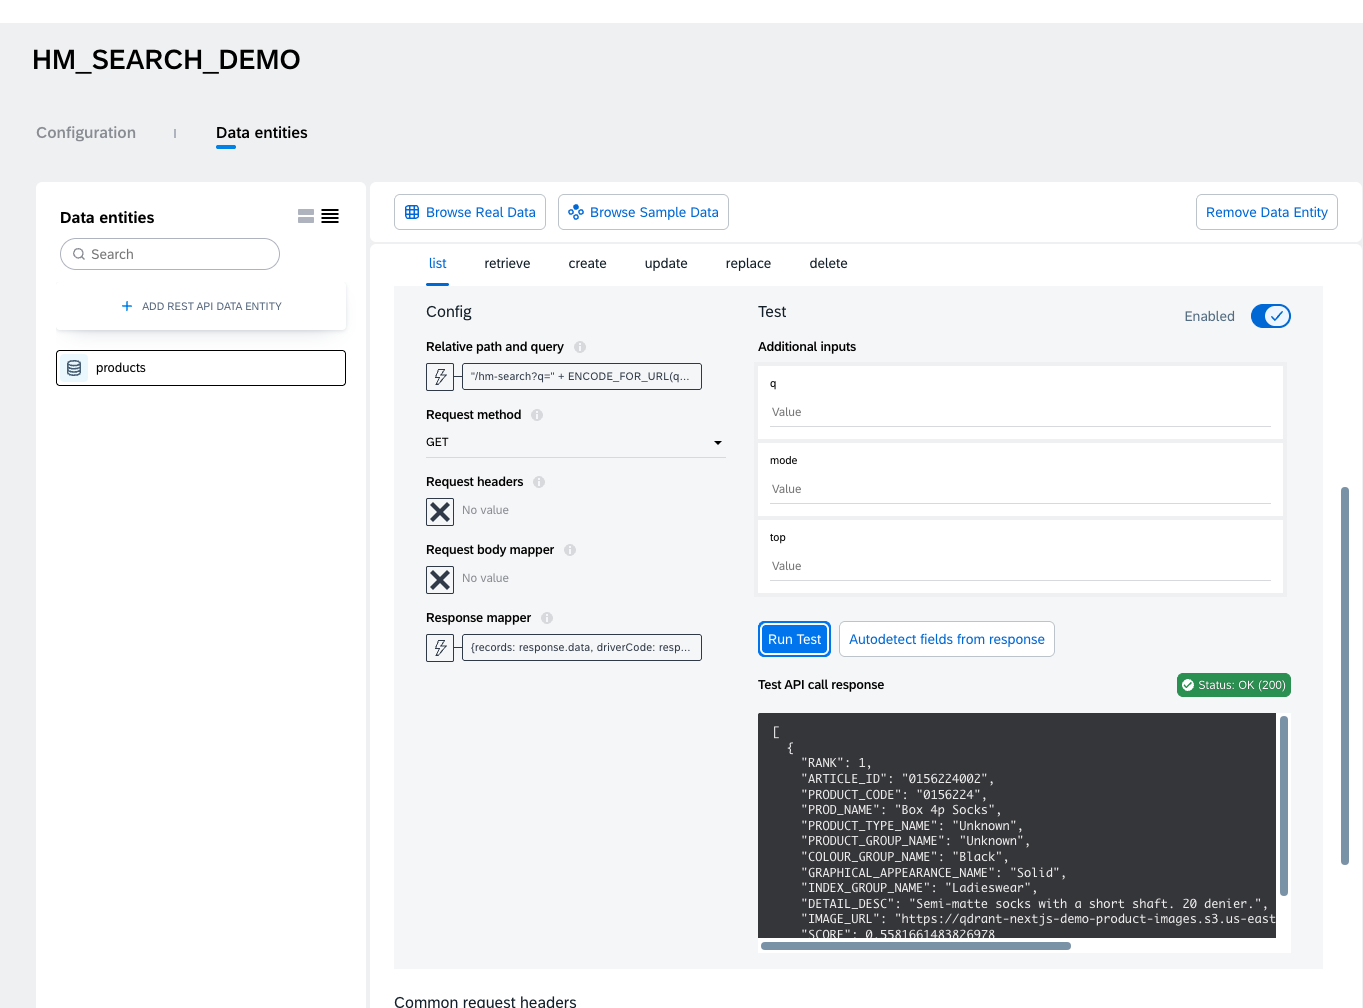
Die Data Entity products mit Pfad-Formel, Additional Inputs und erfolgreichem Test (HTTP 200). 3.2Die Oberfläche und ihre Logik
Die Oberfläche besteht aus Eingabefeld, Umschalter für den Hybrid-Modus, Button „Suchen“ und einem Ergebnisbereich mit Produktname, Attributen, Beschreibung und Bild.
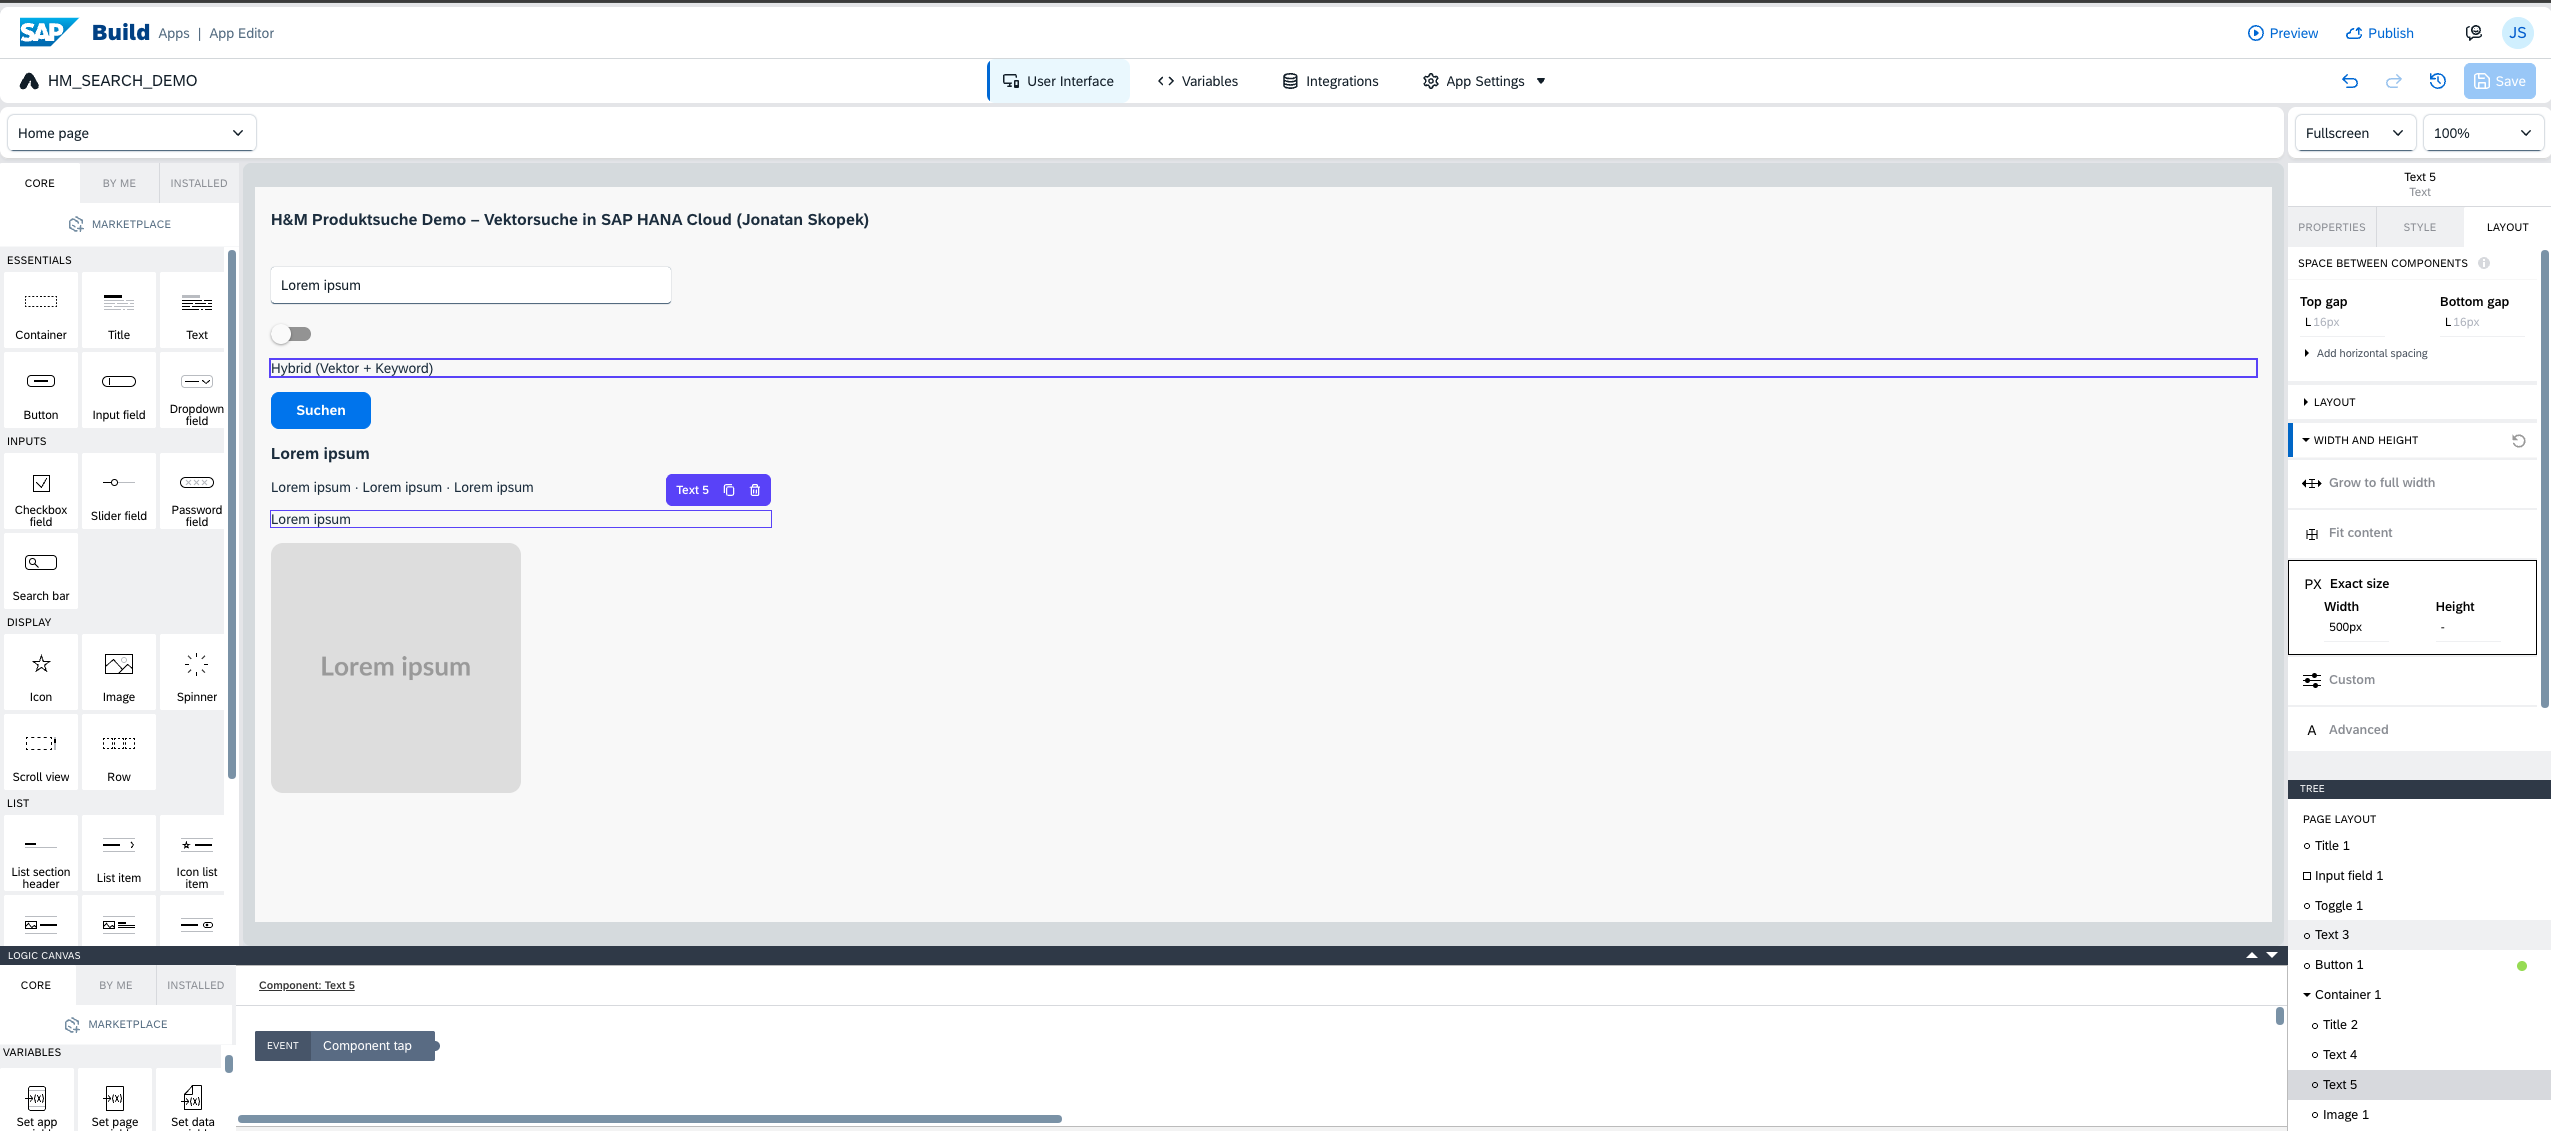
Die App im Editor von SAP Build Apps. Ein Klick auf „Suchen“ startet im Logic Canvas den Baustein Get record collection auf der Data Entity
products. Er übergibt den Suchtext aus dem Eingabefeld und je nach Umschalter den Modusvectoroderhybrid. Daraus entsteht ein REST-Aufruf, der über die Destination an den iFlow geht, wo HANA den Suchtext einbettet, die ähnlichsten Artikel ermittelt und als JSON zurückgibt. Die App legt den besten Treffer in einer Page-Variable ab, und weil Titel, Texte und Bild an diese Variable gebunden sind, erscheint das Ergebnis sofort.Ablauf beim Klick auf „Suchen“: oben die Anfrage bis in die Datenbank, unten die Antwort zurück in die App. Die Schnittstelle liefert bis zu 20 Treffer, eine Ergebnisliste wäre also nur eine kleine Erweiterung. Weil die Bild-URLs des Datensatzes auf einen gelöschten S3-Bucket zeigen, zeigt die App einen Platzhalter mit der Produktart.
Das Layout ist bewusst schlicht gehalten. Bei der App lag der Fokus nicht auf einer ansprechenden Gestaltung, sondern darauf, die Funktion des Szenarios von Ende zu Ende zu zeigen.
Die App im Einsatz: zuerst eine Vektorsuche, dann eine Hybrid-Suche. Das Video zeigt Stärke und Grenze. „Dunkle Jacke für den Winter für Herren“ findet per Vektorsuche einen schwarzen Parka aus der Herrenabteilung. „Regenhose für Damen“ im Hybrid-Modus liefert dagegen eine Outdoor-Hose für Kinder: Die Keyword-Suche arbeitet auf englischen Texten und bringt bei deutschen Freitexten eher Rauschen.
Insgesamt hat sich der Vektor-Modus in den Tests als der zuverlässigere erwiesen. Der Grund ist das mehrsprachige Modell, auf dem das Embedding in HANA beruht: Es erkennt die Bedeutung einer deutschen Anfrage und findet die passenden englischen Produkttexte. Die Keyword-Suche im Hybrid-Modus bleibt dagegen an die Sprache der Daten gebunden.
Fazit
Key Takeaways
- 1Suchlogik gehört in die Datenbank. Als Tabellenfunktion ist die Suche genau einmal definiert. Ob iFlow, CAP-Service oder ein KI-Agent per MCP: Alle rufen dieselbe Funktion auf, statt SQL zu duplizieren. Änderungen am Ranking wirken sofort für jeden Konsumenten, ein Modellwechsel erfordert nur neue Vektoren in der Datenbank.
- 2Embedding in HANA vereinfacht die Architektur. Mit
VECTOR_EMBEDDINGbraucht keine Schicht davor ein eigenes Sprachmodell, und die Daten verlassen die Datenbank nicht. Das spart einen zusätzlichen Dienst samt Betrieb. Die Rechenzeit für den Erstaufbau großer Kataloge sollte man einplanen. - 3Mehrsprachigkeit muss von Anfang an berücksichtigt werden. Ein rein englisches Modell scheitert an deutschen Anfragen und liefert Hosen statt Sommerkleider. Das mehrsprachige HANA-Modell findet die englischen Produkttexte dagegen meist treffsicher und versteht sogar Zielgruppen wie „für Herren“.
- 4Hybrid ist nicht automatisch besser. Keywords vergleichen Wörter, nicht Bedeutungen. Bei Produktnamen hilft das. Bei ganzen Sätzen treffen sie aber auch Füllwörter, und deutsche Anfragen auf englische Texte erzeugen Rauschen. Welche Suchart greift, sollte deshalb pro Anfrage entschieden werden.
Das Ergebnis ist eine semantische Produktsuche komplett auf SAP-Komponenten, ohne separate Vektordatenbank und ohne externen Embedding-Dienst.
Das Muster ist dabei keineswegs auf Webshops beschränkt, und Embeddings können mehr als suchen. Dieselben Bausteine, also VECTOR_EMBEDDING und COSINE_SIMILARITY, tragen ganz unterschiedliche Anwendungsfälle:
- Semantische Suche: Inhalte werden nach Bedeutung statt nach exakten Begriffen gefunden. Neben der Produktsuche gilt das zum Beispiel für Materialstämme oder Ersatzteilkataloge, in denen Anwender beschreiben, was sie suchen, aber die genaue Bezeichnung nicht kennen.
- Service Requests: Zu einem eingehenden Ticket werden automatisch die passenden FAQs, Dokumentationen oder ähnliche, bereits gelöste Tickets gefunden.
- Semantic Threat Intelligence: Neue Sicherheitsmeldungen, Log-Einträge oder Threat-Reports werden mit bekannten Angriffsmustern und früheren Vorfällen verglichen, auch wenn Angreifer oder Analysten ganz andere Worte verwenden.
- Klassifizierung: Statt nach dem ähnlichsten Dokument sucht man nach der ähnlichsten Kategorie. Dafür werden kurze Beschreibungen der Kategorien eingebettet, und jeder Text wird der Kategorie zugeordnet, deren Vektor ihm am nächsten liegt. Das funktioniert sogar ohne Trainingsdaten, zum Beispiel um Tickets automatisch einem Team zuzuweisen.
- Sentimentanalyse: Ein Sonderfall der Klassifizierung mit Kategorien wie „positiv“, „neutral“ und „negativ“, etwa für Kundenfeedback, Produktbewertungen oder Service-Tickets.
Alle diese Fälle lassen sich mit derselben Architektur umsetzen: Embedding und Ähnlichkeitsberechnung direkt in SAP HANA Cloud, bereitgestellt über einen Webservice für Apps, Prozesse oder Agenten.
Quellen und Links
- Hugging Face: Qdrant/hm_ecommerce_products (CC BY 4.0)
- Kaggle: H&M Personalized Fashion Recommendations
- SAP News: Vector Engine in SAP HANA Cloud allgemein verfügbar
- SAP Help: VECTOR_EMBEDDING Function
- SAP Help: CREATE VECTOR INDEX (HNSW)
- SAP Learning: Text Embedding in SAP HANA Cloud
- OpenAI: Embeddings Guide (Einsatzzwecke wie Suche, Clustering, Klassifizierung)
- Microsoft Learn: File Search mit Vector Stores (Azure OpenAI)
- placehold.co für die Platzhalterbilder
SAP, SAP HANA, SAP BTP, SAP Integration Suite und SAP Build sind Marken oder eingetragene Marken der SAP SE. H&M und alle weiteren genannten Produkt- und Firmennamen sind Marken ihrer jeweiligen Inhaber. Die Demo nutzt ausschließlich den öffentlichen Datensatz und steht in keiner Verbindung zum Unternehmen H&M. Der Beitrag gibt die persönliche fachliche Einschätzung des Autors wieder; Angaben zu Produkten Dritter erfolgen ohne Gewähr.