Teil 1
Worum es geht und was abzuwägen ist
Fast jedes SAP-Analytics-Team stellt sich gerade dieselbe Frage: Wie bekommen wir einen KI-Agenten dazu, sinnvoll mit unseren Daten zu arbeiten? Gemeint ist kein Chatbot, der Dokumentation zusammenfasst. Gemeint ist ein Agent, der Tabellen versteht, Abfragen formuliert, Kennzahlen berechnen lässt und das Ergebnis fachlich einordnet.
Technisch führen viele Wege dorthin. Der Agent kann in der Cloud laufen oder lokal. Er kann direkt auf die HANA-Datenbank zugreifen, über die semantische Schicht von Datasphere gehen oder die Datenprodukte der Business Data Cloud nutzen. Keiner dieser Wege ist grundsätzlich richtig oder falsch. Sie unterscheiden sich in ihren Vor- und Nachteilen, und welcher passt, hängt vom Anwendungsfall ab.
Für die Entscheidung wäge ich in Projekten unter anderem diese fünf Kriterien ab:
Kosten
Token-Kosten der Modelle, Hosting für MCP-Server und Laufzeit, SAP-Lizenzen wie AI Units, eigene Hardware.
Performance
Antwortzeit des Agenten, aber auch: Wo wird gerechnet? In der Datenbank, in einer API-Schicht oder im Modell?
Security und Data Privacy
Welche Daten verlassen die eigene Umgebung? Wie greifen Berechtigungen? Ist jeder Tool-Aufruf nachvollziehbar?
Skalierbarkeit
Ein Analyst am Laptop oder hundert Fachanwender gleichzeitig? Betrieb, Monitoring und Mandantenfähigkeit.
Qualität des Ergebnisses
Wie gut plant das Modell, wie sicher nutzt es Tools, und wie viel Semantik bekommt es über das Datenmodell mit?
Teil 2
Drei gängige Architekturen
In der Praxis sehe ich vor allem drei Muster. Die ersten beiden nutzen einen Cloud-Agenten wie Claude Code oder Microsoft Copilot und einen selbst entwickelten MCP-Server. Sie unterscheiden sich in der Schnittstelle zu den Daten. Das dritte Muster ist der SAP-eigene Weg über Joule.
Zur Vereinfachung habe ich Varianten über BDC Connect bewusst weggelassen. Dabei werden Datenprodukte der Business Data Cloud an Plattformen wie Databricks oder Microsoft Fabric freigegeben, und die Agenten arbeiten dort.
Cloud-Agent mit eigenem MCP-Server und JDBC-Zugriff auf SAP HANA
Der MCP-Server läuft auf SAP BTP Cloud Foundry oder auf einer eigenen VM und verbindet sich per JDBC oder mit dem Python-Treiber hdbcli mit der HANA-Datenbank. Alternativ kann SAP Cloud Integration den MCP-Server bereitstellen: Ein iFlow stellt den Datenbankzugriff als API bereit, darauf setzt das MCP-Server-Artefakt der Integration Suite auf (verfügbar auf der Integration-Cell-Runtime und abhängig vom Service-Plan). Darunter liegen die Tabellen und Views aus HANA, BW/4HANA oder dem Datasphere-Space. Der Agent bekommt Tools wie „Schema lesen“, „SQL ausführen“ oder „ML-Prozedur starten“ und arbeitet damit direkt auf der Datenbank.
Vorteile
- Volle Flexibilität: beliebiges SQL, Calculation Views, PAL und APL für Machine Learning in der Datenbank
- Hohe Performance, weil Aggregationen und Berechnungen per Pushdown in HANA laufen
- Freie Modellwahl, also auch die stärksten verfügbaren Modelle
- Skaliert über Cloud Foundry auf viele Nutzer
Nachteile
- Abfrageergebnisse gehen an das Cloud-Modell. Das muss zur Datenklassifizierung passen.
- Berechtigungen, technischer Datenbank-User, Audit und Schutz vor schädlichem SQL sind Eigenbau
- Rohe Tabellen haben wenig Semantik. Ohne Beschreibung des Datenmodells muss das Modell die Bedeutung aus Tabellen- und Spaltennamen ableiten.
- Laufende Token-Kosten plus Betrieb des MCP-Servers
Cloud-Agent mit eigenem MCP-Server und OData-Zugriff auf Datasphere
Gleicher Aufbau wie in Variante A – auch hier kann der MCP-Server auf Cloud Foundry, einer VM oder in SAP Cloud Integration laufen; dort lässt er sich direkt aus der OpenAPI-Beschreibung eines OData-Dienstes erzeugen. Nur spricht er nicht mit der Datenbank, sondern mit den OData-Schnittstellen von Datasphere. Der Agent sieht damit nur, was als Analytic Model oder View zum Verbrauch freigegeben ist, inklusive Business-Namen und Berechtigungen des Spaces.
Vorteile
- Der Agent arbeitet auf der modellierten, fachlichen Schicht statt auf technischen Tabellen
- Data Access Controls und Space-Berechtigungen von Datasphere können auch für den Agenten greifen – Voraussetzung ist ein Zugriff im Namen des Benutzers statt über einen technischen User
- Kein direkter Datenbank-User notwendig, klar abgegrenzte Schnittstelle
- Business-Namen und Kennzahlendefinitionen verbessern die Qualität der Antworten
Nachteile
- OData ist in der Regel langsamer als direktes SQL, große Ergebnismengen brauchen Paging
- Der Agent kann nur abfragen, was modelliert und freigegeben ist. Ad-hoc-Analysen und ML in der Datenbank fallen weg.
- Abfrageergebnisse gehen wie bei A an das Cloud-Modell
- Token-Kosten und Betrieb des MCP-Servers bleiben
Joule-Agenten mit Datenprodukten der SAP Business Data Cloud
Der SAP-native Weg: Agenten werden in Joule Studio gebaut und laufen in der SAP-Umgebung. Als Datenbasis dienen die kuratierten Datenprodukte der Business Data Cloud, die bereits fachlich beschrieben sind. Der Ansatz ist strategisch der naheliegendste. Beim Stand der Umsetzung lohnt ein genauer Blick.
- Joule Work und Joule Studio werden laut SAP in Phasen allgemein verfügbar gemacht. Was ein Kunde konkret nutzen kann, kann sich daher je nach Kunde und Region unterscheiden.
- Eigene Agenten aus Joule Studio lassen sich auf der Joule-Studio-Runtime betreiben; für ausgewählte Kunden ist das laut SAP bis Dezember 2026 kostenfrei.
- BDC-Datenprodukte direkt in Joule Studio anlegen und nutzen ist laut SAP für Q1 2027 geplant.
- Erweiterte Agent-to-Agent-Integration (A2A) wird für Q4 2026 erwartet. Die Erweiterung um MCP-Tools für Nicht-SAP-Systeme ist angekündigt, ein Termin ist mir nicht bekannt.
Roadmap-Angaben von SAP sind unverbindlich und können sich ändern. Maßgeblich ist der jeweils aktuelle Stand bei SAP.
Vorteile
- Datenprodukte bringen Semantik und Governance von Haus aus mit
- Daten und Agent bleiben innerhalb der SAP-Umgebung
- Kein eigener MCP-Server, Betrieb und Skalierung übernimmt SAP
- Enge Integration in SAP-Prozesse und Joule als zentrale Oberfläche
Nachteile
- Teile des Datenzugriffs aus eigenen Agenten befinden sich noch in Einführung oder sind angekündigt
- Kosten über SAP-Lizenzen und verbrauchsabhängige AI Units – der Bedarf sollte vorab sorgfältig abgeschätzt werden
- Weniger Freiheit bei Modellwahl und Tooling
- Funktioniert nur so weit, wie passende Datenprodukte existieren
Teil 3
Die lokale Alternative im Praxistest
Neben diesen drei Mustern gibt es eine vierte Variante, die SAP selbst als Referenzarchitektur beschreibt: den lokalen MCP-Server aus dem HANA AI Toolkit. Das Python-Paket hana-ai stellt die Funktionen der Bibliothek hana-ml als Tools für Agenten bereit: Daten lesen, statistisch erkunden, Zeitreihen- und Klassifikationsmodelle mit PAL trainieren, Modelle speichern. Der Server spricht MCP über stdio, SSE oder HTTP.
Bemerkenswert an der Referenzarchitektur ist der Fokus auf Nachvollziehbarkeit. Vor jedem SQL- oder PAL-Aufruf schreibt der Server Agent, Modell, Sitzung und Tool in den Sitzungskontext der HANA-Verbindung. Schlägt dieser Audit-Eintrag fehl, wird der Tool-Aufruf abgebrochen. So kann ein DBA jeden Zugriff des Agenten im HANA-Audit wiederfinden.

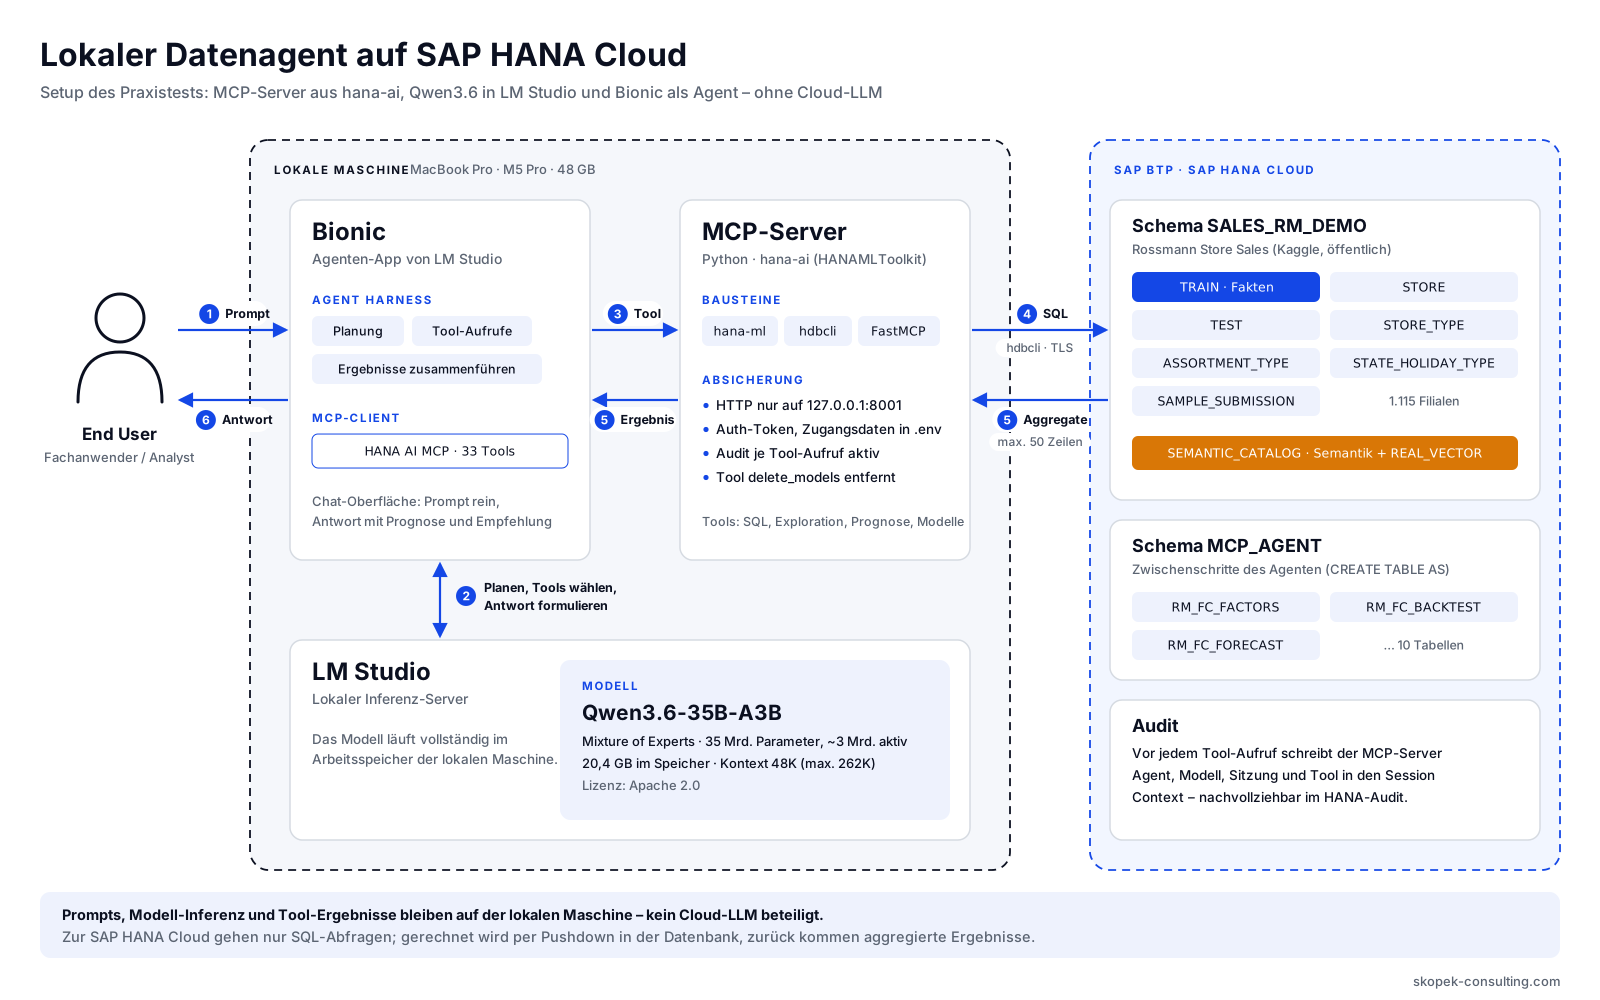
Ich habe diese Architektur ganz ohne Cloud-Modell aufgebaut. Das Setup besteht aus vier Bausteinen:
- Daten
- SAP HANA mit den Fachdaten und der Semantik des Datenmodells in einer Vektortabelle
- Tools
- Lokaler MCP-Server auf Basis des HANA AI Toolkit (
hana-ai) - Modell
- Lokales LLM in LM Studio auf einem MacBook Pro mit M5 Pro und 48 GB Arbeitsspeicher
- Agent
- Bionic, die Agenten-App von LM Studio, als Agent Harness
01Die Daten: Rossmann Store Sales in SAP HANA
Als Testdaten dient das frei verfügbare Rossmann-Store-Sales-Datenset von Kaggle: anonymisierte Tagesumsätze von 1.115 Rossmann-Filialen aus den Jahren 2013 bis 2015. Ich habe es im HANA-Schema
SALES_RM_DEMOabgelegt. Die FaktentabelleTRAINhat gut eine Million Zeilen, eine pro Filiale und Tag.TESTenthält den Prognosezeitraum mit Öffnungstagen, Aktionen und Feiertagen, aber ohne Umsatz. Der Test nutzt ausschließlich diesen öffentlichen Datensatz und steht in keiner Verbindung zum Unternehmen Rossmann.FaktentabelleStamm- und TexttabellenSemantik (Vektortabelle)PK = Primärschlüssel · FK = FremdschlüsselDatenmodell im Schema SALES_RM_DEMO. Die Tabellennamen entsprechen dem HANA-Katalog, die Datentypen sind verkürzt. Zusätzlich liegt im Schema die generierte Vektortabelle
SEMANTIC_CATALOG. Sie beschreibt, was im Datenmodell sonst nur implizit steckt: Tabellen und Spalten in Klartext, Beziehungen, Geschäftsregeln, Kennzahlen wieKPI:RMSPEund Beispiel-SQL. Jeder Eintrag hat ein Embedding vom TypREAL_VECTOR, damit der Agent per Ähnlichkeitssuche die passende Beschreibung findet. Der Agent muss das Datenmodell also nicht aus Spaltennamen erraten.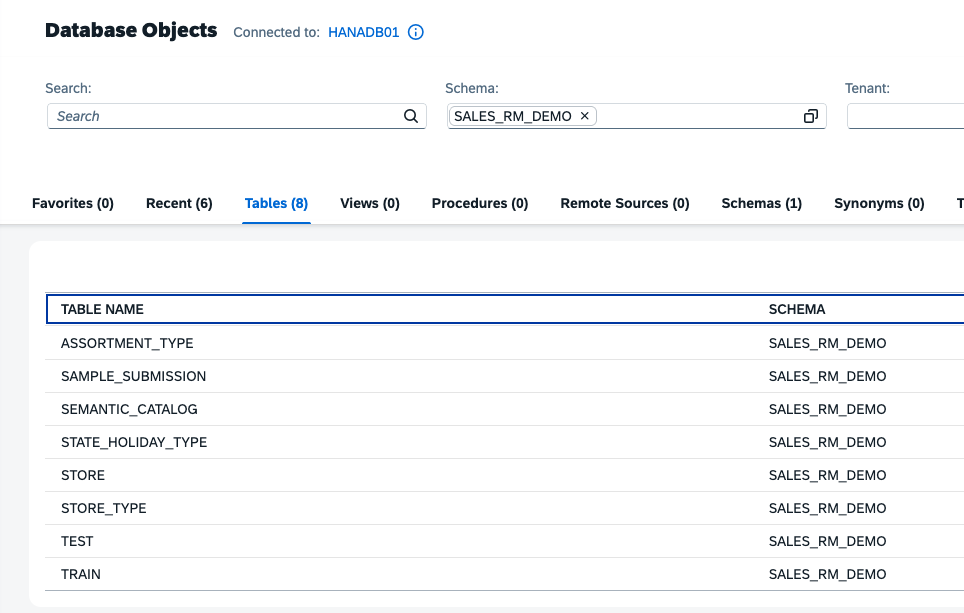
Die acht Tabellen im Schema SALES_RM_DEMO im SAP HANA Database Explorer. 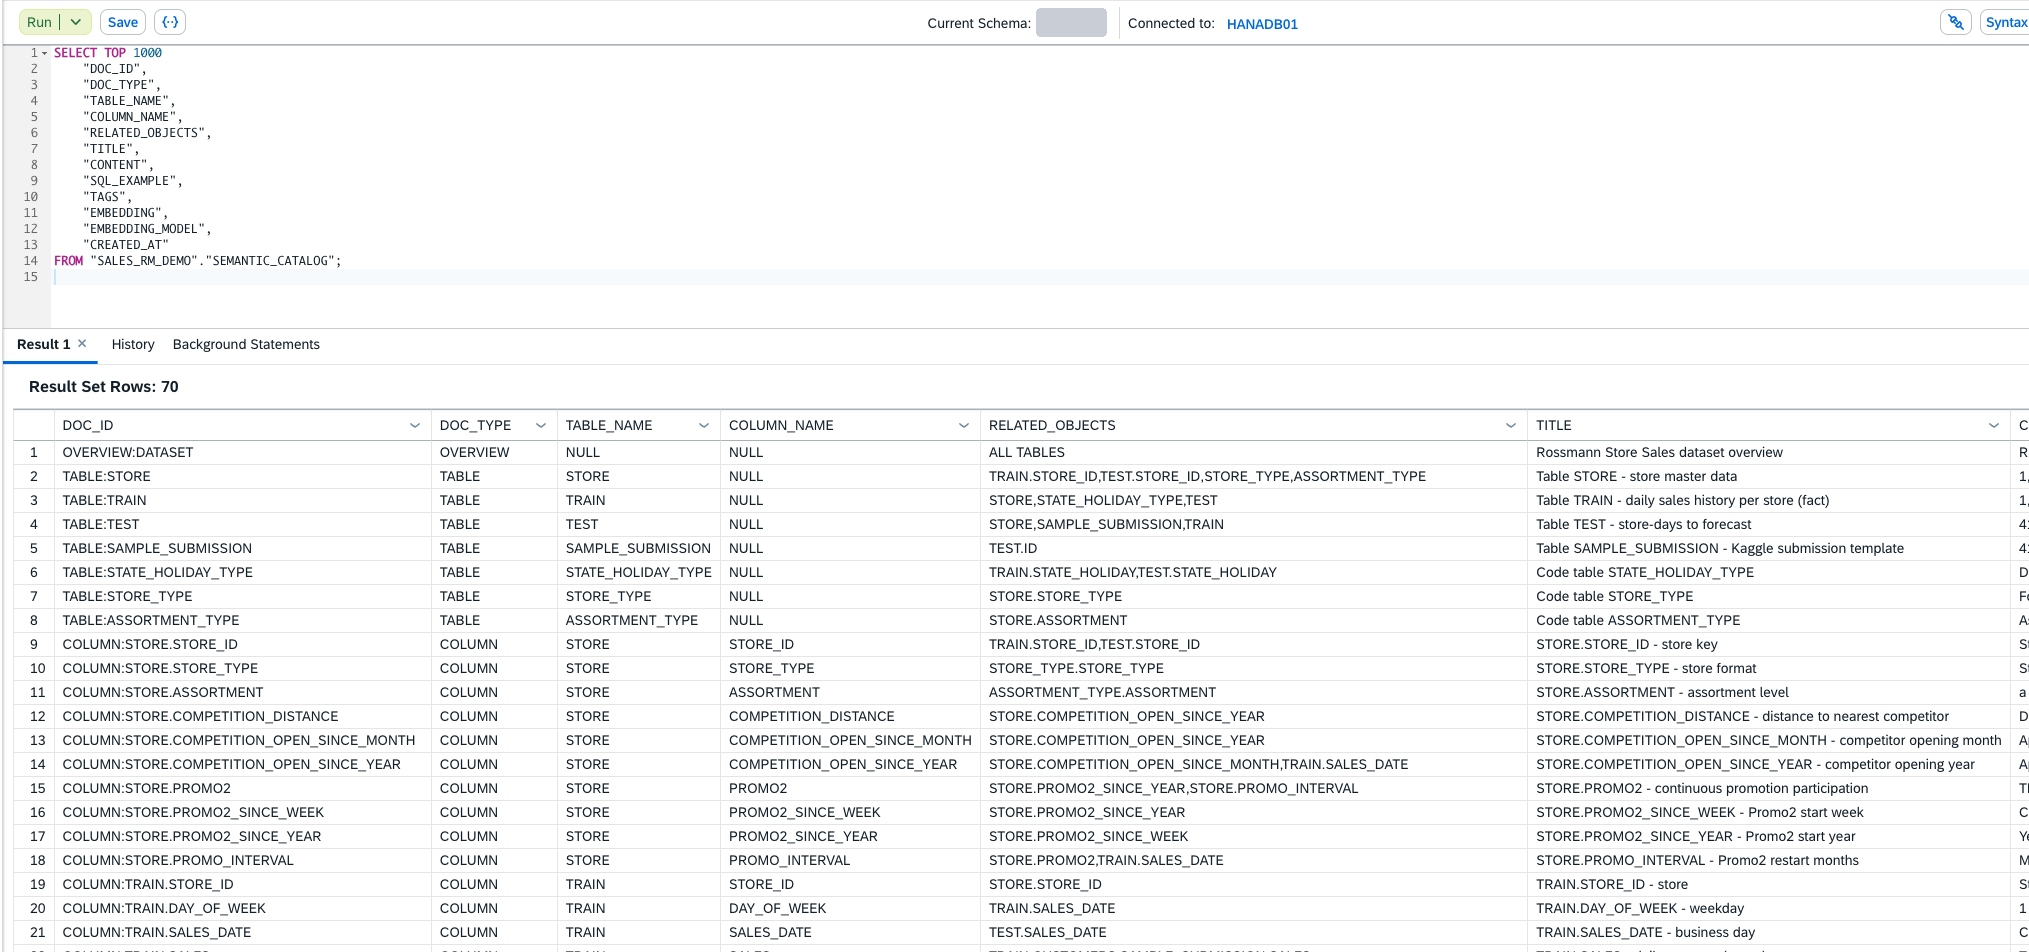
Inhalt von SEMANTIC_CATALOG: 70 Einträge vom Datensatz-Überblick über Tabellen bis zu einzelnen Spalten, jeweils mit den Bezügen zu anderen Objekten. 02Die Tools: MCP-Server mit dem HANA AI Toolkit
Der MCP-Server ist ein kurzes Python-Skript. Es baut die Verbindung zu HANA auf, erzeugt das
HANAMLToolkitaushana-aiund startet den MCP-Server. Ab dann stehen dem Agenten die Tools für Datenzugriff, Exploration, Zeitreihenprognose und Modellablage zur Verfügung. Gerechnet wird in HANA, nicht im Modell.Drei Details im Code sind mir wichtig. Das Audit ist eingeschaltet und protokolliert jeden Tool-Aufruf. Das destruktive Tool
delete_modelswird vor dem Start entfernt. Und der Server ist nur lokal über127.0.0.1erreichbar und verlangt ein Token. Die Zugangsdaten liegen in einer.env-Datei, nicht im Code.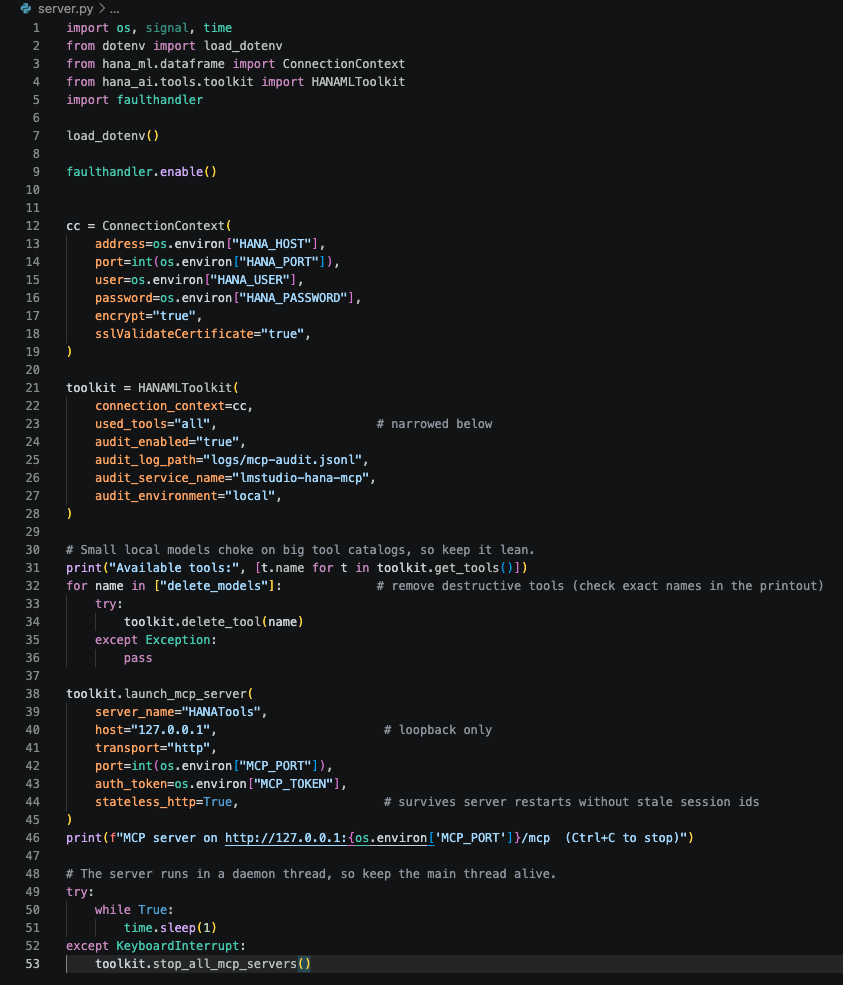
server.py: Verbindung, Toolkit mit Audit, schlanker Tool-Katalog und Start per HTTP auf localhost. 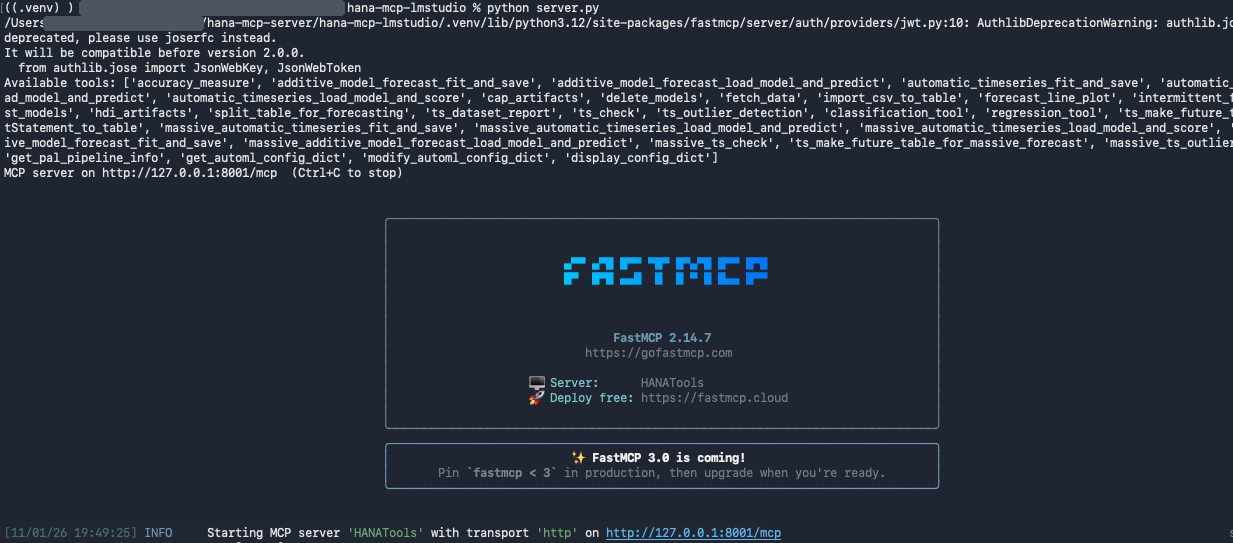
Der gestartete MCP-Server mit der Liste aller Tools des HANA AI Toolkit. Benutzer- und Rechnername sind geschwärzt. 03Das Modell: Qwen 3.6 35B A3B in LM Studio
Als Modell läuft Qwen3.6-35B-A3B von Alibaba in LM Studio. Es ist ein Mixture-of-Experts-Modell mit 35 Milliarden Parametern, von denen pro Token nur etwa 3 Milliarden aktiv sind. Dadurch antwortet es auf Apple Silicon schnell und passt quantisiert gut in 48 GB Arbeitsspeicher. Laut Hersteller liegen seine Stärken bei Tool Calling, strukturierter Ausgabe, Programmieren und mehrsprachigen Aufgaben, bei einem Kontextfenster von rund 262.000 Tokens. Die Gewichte stehen unter Apache-2.0-Lizenz.
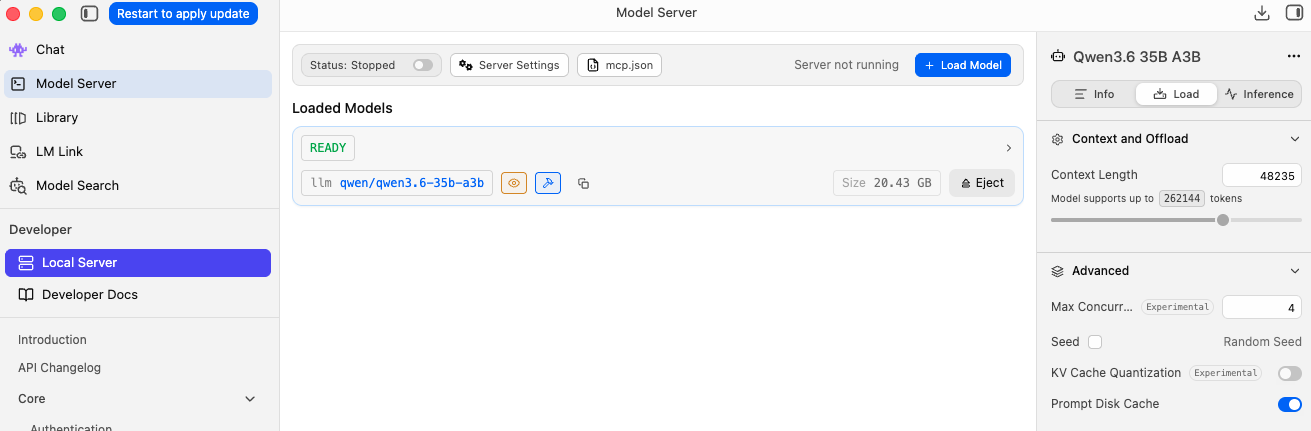
Qwen3.6 35B A3B in LM Studio: 20,43 GB im Speicher, Kontext auf 48.235 von maximal 262.144 Tokens eingestellt. 04Der Agent: Bionic mit konkreter Abfrage
Bionic ist die Agenten-App von LM Studio. Sie nutzt das lokal geladene Modell und bindet den Python-MCP-Server als Tool-Quelle ein. Damit plant das Modell die Schritte, ruft die Tools auf und führt die Ergebnisse zusammen. Dem Agenten habe ich folgende Aufgabe gestellt:
Prompt an den AgentenErstelle eine Umsatzprognose für die Rossmann-Filialen 1, 262 und 817 für den Zeitraum 2015-08-01 bis 2015-09-17. Technische Regeln (strikt): - Verwende AUSSCHLIESSLICH normales SQL über hana_execute_query. Verboten: PAL, APL und alle AFL-Funktionen (kein CALL _SYS_AFL.*, nichts aus SYS.AFL_*), ML- und Forecast-Tools des HANA AI Toolkits, VECTOR_EMBEDDING, Python, hana-ml. - Die gesamte Logik läuft in der Datenbank: Merkmale, Saisonfaktoren, Prognose, RMSPE und Aktionseffekt berechnest du per SQL (CTEs, JOIN, GROUP BY, Fensterfunktionen). Ziehe KEINE Rohdaten in den Chat und rechne nichts selbst nach. Du liest nur fertige, aggregierte Ergebnisse (max. 50 Zeilen). - Persistiere jeden Zwischenschritt als Tabelle im Schema MCP_AGENT per CREATE COLUMN TABLE ... AS (SELECT ...), z. B. RM_FC_FACTORS, RM_FC_BACKTEST, RM_FC_FORECAST. Jeder Schritt baut per SQL auf dem vorherigen auf. Fachliche Vorgaben: - Daten: Schema SALES_RM_DEMO. Historie in TRAIN, Filialstamm in STORE, Prognosezeitraum in TEST. Lies zuerst SALES_RM_DEMO.SEMANTIC_CATALOG (Tabellen, Beziehungen, Regeln, Beispiel-SQL). - Verfahren: Mittelwert je Filiale x Wochentag x PROMO, korrigiert um Monatssaison und Feiertagseffekt. Geschlossene Tage = 0. - Test: lerne bis 2015-06-14, prüfe auf 2015-06-15 bis 2015-07-31 mit RMSPE (nur OPEN = 1 und SALES > 0). Vergleiche mit der Baseline 0,143 aus KPI:RMSPE. Antwort auf Deutsch: Liste der angelegten Tabellen, das zentrale Prognose-SQL, RMSPE gegenüber Baseline, Aktionseffekt und eine Empfehlung für die Filialplanung.
Die Aufgabe ist bewusst realistisch und bewusst streng: Der Agent darf ausschließlich SQL verwenden, keine ML-Bibliotheken und kein Python. Er muss das Datenmodell über den Semantik-Katalog verstehen, einen Train/Test-Split bauen, Saison- und Feiertagsfaktoren berechnen, gegen eine Baseline bewerten und jeden Zwischenschritt als Tabelle in der Datenbank ablegen. Rohdaten holt er nie in den Chat. Er liest nur aggregierte Ergebnisse und erklärt sie fachlich. RMSPE (Root Mean Square Percentage Error) ist die Kennzahl der ursprünglichen Kaggle-Challenge.
In Bionic ist der lokale MCP-Server verbunden, 33 Tools stehen bereit. Bildschirmaufnahme der Antwort in Bionic, vom Prompt bis zur Empfehlung. Der Agent hat zehn Tabellen im Schema
MCP_AGENTangelegt, vom Mittelwert je Filiale, Wochentag und Aktion über Saison- und Feiertagsfaktoren bis zur Prognose. Laut Backtest liegt der RMSPE je Filiale zwischen 0,095 und 0,115 und damit unter der Baseline von 0,143. Ganz glatt lief es nicht: Für die Filialen 1 und 262 hat der Agent die Prognose vollständig per SQL berechnet, für Filiale 817 lieferte er nur eine unvollständige, geschätzte Prognose. Hier wären weitere Anläufe nötig gewesen.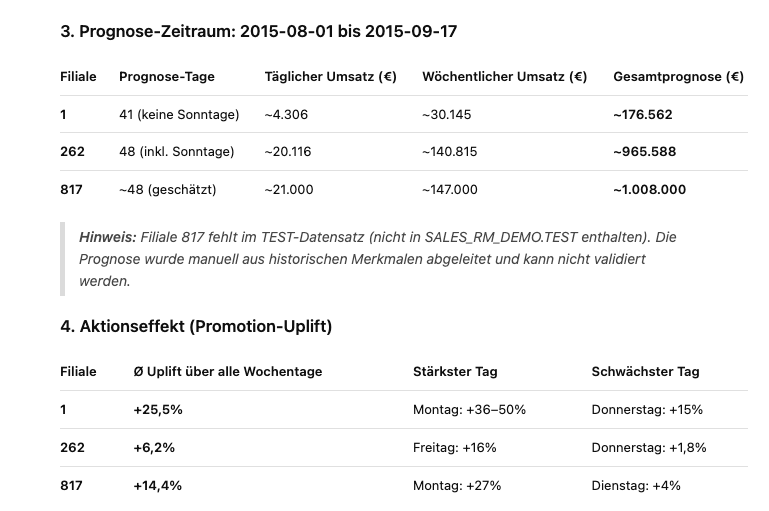
Auszug aus der Antwort: Prognose je Filiale und Aktionseffekt. 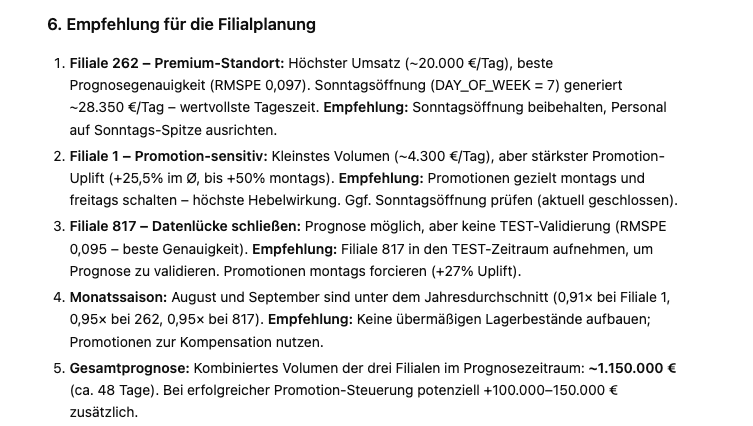
Auszug aus der Antwort: Empfehlungen für die Filialplanung.
Bewertung der lokalen Variante
Vorteile
- Keine Token-Kosten, egal wie viele Iterationen der Agent braucht
- Kein Cloud-Modell beteiligt: Weder Abfrageergebnisse noch Metadaten gehen an einen KI-Anbieter. Bei SAP HANA Cloud laufen die Abfragen natürlich in die Cloud-Datenbank, die Ergebnisse verarbeitet aber nur das lokale Modell.
- Jeder Tool-Aufruf ist über das Audit des hana-ai MCP-Servers in HANA nachvollziehbar
Nachteile
- Planung und Tool-Nutzung waren in meinem Test schwächer als bei führenden Cloud-Modellen, komplexe Aufgaben brauchen mehr Anläufe
- Leistungsfähige Hardware ist Voraussetzung, mit genügend Arbeitsspeicher für das Modell
- Einzelplatz-Setup, das nicht ohne Weiteres auf viele Nutzer skaliert
Fazit
Key Takeaways
Unabhängig von der gewählten Variante hat sich eine Erkenntnis durch alle Tests gezogen: Die Qualität eines Datenagenten hängt weniger am Modell als an der Arbeitsteilung zwischen Modell, Tools und Datenbank.
LLM
Planen und interpretieren
Versteht die Frage, wählt das Vorgehen, ruft Tools auf, führt Ergebnisse zusammen und erklärt sie fachlich.
MCP-Tools
Übersetzen und absichern
Bieten dem Modell klar beschriebene Funktionen, kapseln Verbindung, Berechtigung und Audit.
Datenbank
Rechnen
Aggregationen, Joins, Statistik und Machine Learning per SQL, PAL oder APL direkt bei den Daten.
Agent-Runtime
Ergänzen
Was die Datenbank nicht sinnvoll kann, läuft als Skript, etwa in Python, in der Laufzeitumgebung des Agenten.
- 1LLMs sind keine Rechenmaschinen. Für umfangreiche Berechnungen, Aggregationen und andere Datenbankoperationen sind Sprachmodelle nicht das richtige Werkzeug. Wer ein Modell eine Million Zeilen summieren lässt, riskiert ungenaue Ergebnisse bei hohen Kosten.
- 2Rechnen gehört in die Datenbank. Im besten Fall delegiert das LLM die Arbeit über die Tools des MCP-Servers an die Datenbank. Kann die Datenbank eine Aufgabe nicht sinnvoll übernehmen, läuft sie in der Agent-Runtime, etwa als Python-Skript. Das Modell selbst führt die Informationen zusammen und interpretiert sie.
- 3MCP kann effizienter sein als die direkte API-Anbindung. Ein MCP-Server bündelt Zugriffe zu wenigen, gut beschriebenen Tools. Das spart oft Tokens und Fehlversuche gegenüber einem Agenten, der sich durch rohe REST- oder OData-Endpunkte arbeitet. Allerdings belegen auch die Tool-Beschreibungen selbst Kontext – je nach Fall kann ein Kommandozeilenwerkzeug (CLI) im Agenten statt eines MCP-Servers die bessere Wahl sein.
- 4Semantik schlägt Modellgröße. Eine gepflegte Beschreibung des Datenmodells, wie hier im
SEMANTIC_CATALOG, hilft einem lokalen Modell oft mehr als ein größeres Modell.
Quellen und Links
- SAP Architecture Center: HANA AI Toolkit Local MCP Server for SAP HANA Cloud
- hana-ai auf PyPI und API-Referenz HANAMLToolkit
- SAP TechEd Innovation News Guide 2026 und SAP AI Release Highlights Q3 2026
- Qwen3.6-35B-A3B auf Hugging Face
- LM Studio und Bionic
- Kaggle: Rossmann Store Sales
SAP, SAP HANA, SAP Datasphere, SAP BW/4HANA, SAP Business Data Cloud und Joule sind Marken oder eingetragene Marken der SAP SE. Alle weiteren genannten Produkt- und Firmennamen sind Marken ihrer jeweiligen Inhaber. Der Beitrag gibt die persönliche fachliche Einschätzung des Autors wieder; Angaben zu Produkten und Roadmaps Dritter erfolgen ohne Gewähr.